10 月 20 日下午 5 点 08 分,我在 Hacker News 首页看到一条 2,325 分的帖子:DeepInfer,DeepSeek 的推理框架开源了。
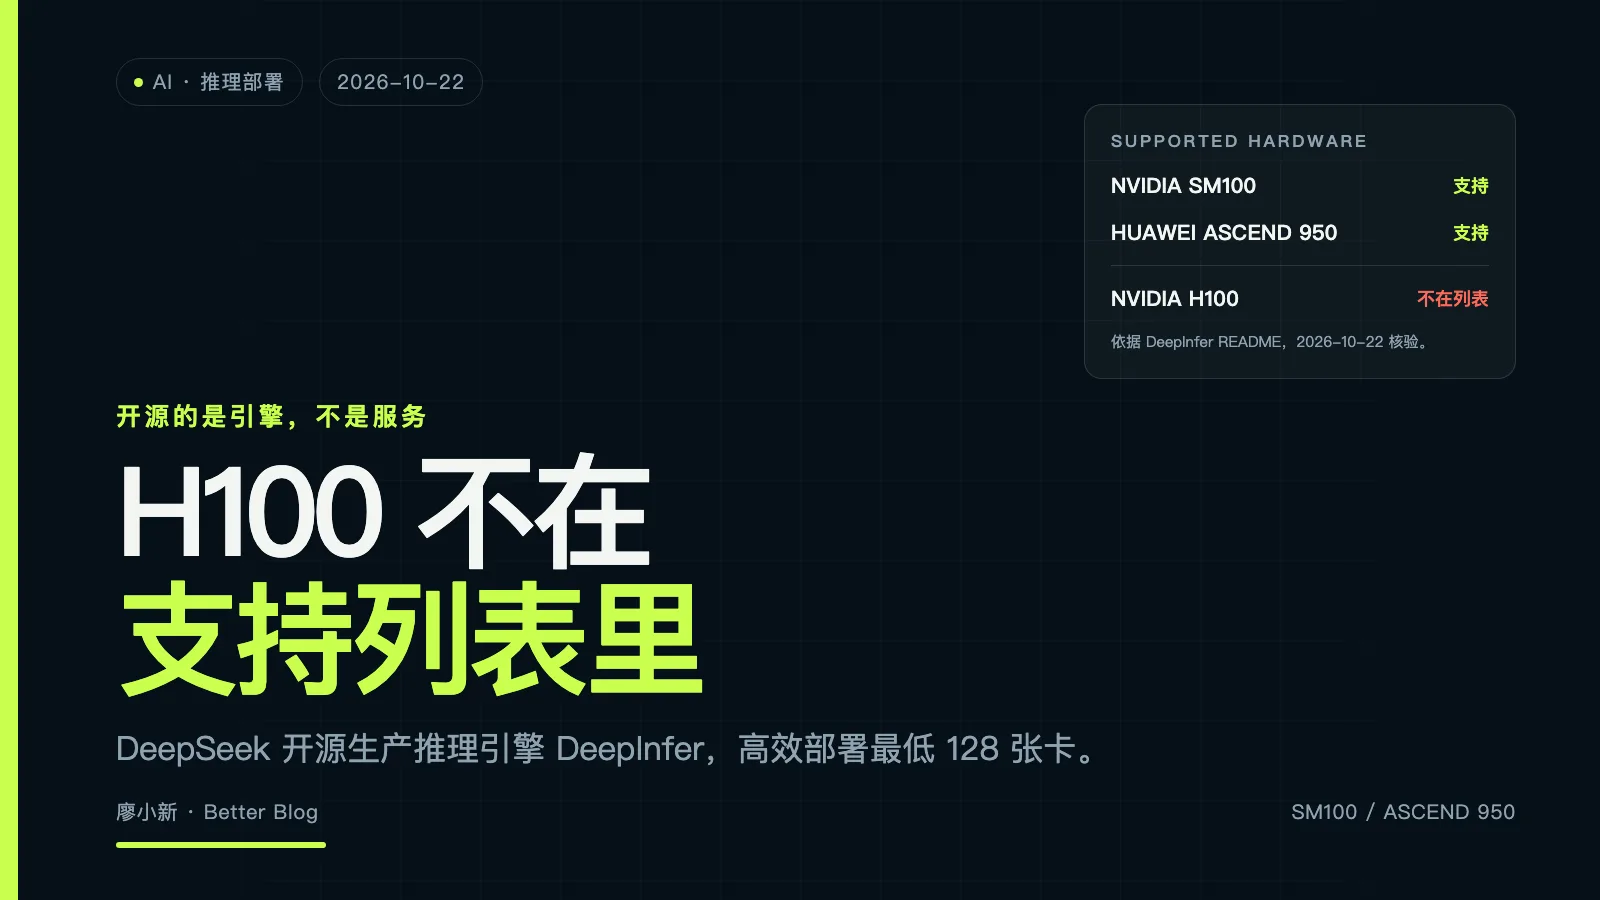
我第一反应是,终于能把 DeepSeek-V4.1-Flash 的推理栈拆开看看。点进去,README 第一屏不是 benchmark,也不是 quick start,而是两行 Supported hardware:NVIDIA SM100 GPUs、Huawei Ascend 950 NPUs。
我手边没有 SM100,也没有昇腾 950。所以这篇要回答的不是「DeepSeek 又赢了没有」,而是:它到底开了什么,谁能用,代价是什么,以及我为什么说它对大多数开发者更像一份参考实现,而不是一个能跑起来的工具。
10 月 20 日下午,HN 首页那条 2,325 分的帖子
先把现场还原一下。
帖子是 2026-10-20 17:08(UTC+8)发到 HN 的,我抓取时是 2,325 分、886 条评论。仓库 deepseek-ai/DeepInfer 的描述很克制:High-performance, large-scale inference framework for DeepSeek models。许可证 Apache-2.0,我抓取时 19,433 stars。
19,433 这个数字看起来涨得很快,但我只有抓取这一刻的一个点,没有历史曲线,所以我不写「暴涨」。同理,2,325 分是抓取时的读数,不是它最终的分数。
这几个数字放在一起,很容易让人以为「DeepSeek 把推理成本打下来了」。我一开始也这么想。
但 README 的第二屏就把我拉回来了。Supported models 只有一行:DeepSeek-V4.1-Flash。Supported hardware 只有两行:NVIDIA SM100、Huawei Ascend 950。不是「优先支持」,不是「适配中」,是只支持这些。
这不是一个通用推理框架的自我介绍。这是一个生产系统的配置单。
HN 的评论区比 README 热闹。评论区有人把 X 上的说法搬了过来:单集群 155 万亿 token/天,$38/卡/小时;有人用「a nuclear bomb」形容这件事,也有人立刻开始算每百万 token 多少钱。还有人问,155 万亿是不是把输入 token 也算进去了。没有人贴出可复现的 benchmark。这个场面很典型:一个基础设施 release,先被当成经济新闻传播。
我顺手看了下仓库结构:deepinfer/、deep_cluster/、csrc/、examples/、doc/、eval/,没有 docker-compose、Helm chart 或 K8s manifest。这个结构本身就在说:它不是给应用开发者准备的产品,是给懂 CUDA 和集群的人准备的一份工程材料。
我又往下翻了翻 Q&A。官方写得很直接:这套东西支撑的是 DeepSeek V4.1 Flash 的大规模在线服务;单集群每天 155 万亿 token;$38/GPU-hour 的 overall revenue,谷时价格。数字很大,大到让人忽略一个前提——它没有说这个集群有多少张卡。
时间线:2025 年说不开源,2026 年 10 月 20 日开了
这件事不是凭空冒出来的。DeepSeek 的 open-infra-index 仓库里有一篇 2025 年 4 月的文档《The Path to Open-Sourcing the DeepSeek Inference Engine》,结论是「不直接开源完整引擎」。理由三条,都是工程原因:引擎基于一年多前的 vLLM 分支,改得太多;和内部集群管理工具耦合;团队小,维护不动一个大开源项目。
18 个月后,2026 年 10 月 20 日,DeepInfer 的 initial commit 出现在 GitHub 上。同一天,Q&A 文档里多了一句「Today we are open-sourcing DeepInfer, our inference framework for large-scale cloud services.」
这两件事不矛盾。2025 年说的是「完整引擎」,2026 年开的是「offline inference 版本」,KV cache 和跨 DP 负载均衡仍然没开。旧文档里的三条顾虑,至少后两条今天还成立。
那篇文档里还有一句容易被忽略的话:DeepSeek 说会在新模型发布前,主动同步推理侧的工程工作,让社区在 Day-0 拿到 SOTA 支持。DeepInfer 更像是这句话的延续:先把推理栈的一部分公开,让外部团队能按它的方式部署,而不是把整个在线系统搬出来。
| 时间(UTC+8) | 主体 | 发生了什么 | 性质 |
|---|---|---|---|
| 2025-04-14(提交日) | DeepSeek | open-infra-index 旧文档:不直接开源完整引擎 | 一手,已读 |
| 2026-10-20 12:09 | DeepSeek | 初始 commit d585e654,README、Q&A、examples 同日出现 |
一手,已读 |
| 2026-10-20 17:08 | Hacker News | 帖子 2,325 分、886 条评论 | 第三方,已抓 |
| 2026-10-20 19:03 | DeepSeek | Q&A 文档更新,写下「Today we are open-sourcing」 | 一手,已读 |
| 2026-10-21 12:55 | DeepSeek | 10-21 的 push,Bump DeepEP(#157) | 一手 |
所以这不是一次「憋了两年终于全开」的故事,更像「先把能拆的拆出来,拆不动的继续留在机房」。
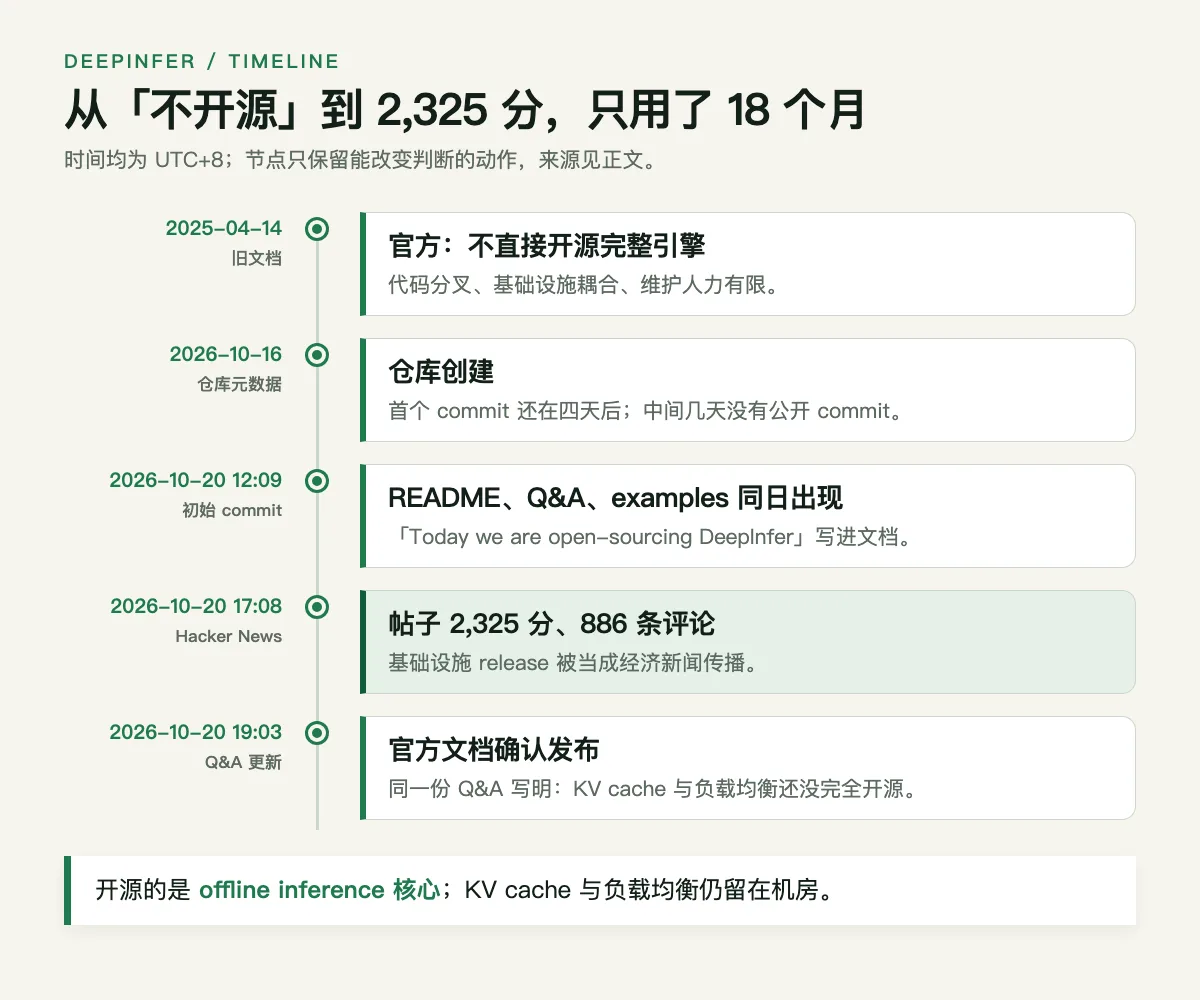
仓库元数据显示它创建于 2026-10-16,但第一个 commit 是 10-20 12:09。中间几天它在干什么,我不知道,也没有证据说它是私有准备。这个空白不影响判断,但我不想把它写成「10 月 16 日就发布了」。
它开了什么:一个模型、两种芯片、三块没给
一句话定位:DeepSeek 生产推理栈的离线参考实现。
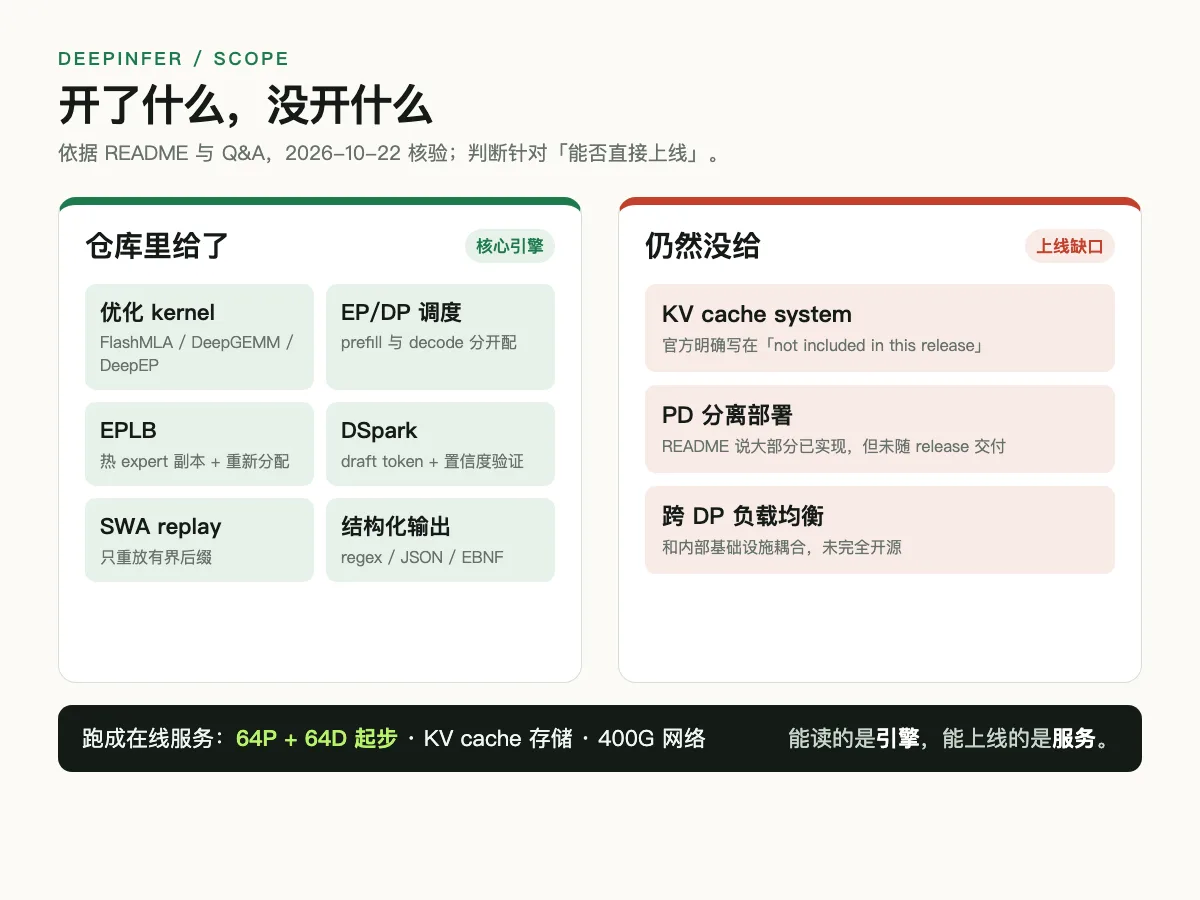
开了的东西不少。优化过的 kernel(FlashMLA、DeepGEMM、DeepEP、DeepSelect、TileLang)、Attention DP/CP、MoE EP + EPLB、DSpark 投机解码、SWA bounded replay、异步调度、batch-invariant、确定性采样、结构化输出。这些名词单拎一个出来都能写一篇文章,但它们不是我要讲的主峰。
没开的东西更关键。README 自己列了一节「Required for a complete inference service (not included in this release)」:KV cache system、VE/Prefill/Decode disaggregation、跨 DP 副本的负载均衡。Q&A 进一步承认:KV cache 管理和负载均衡和内部基础设施耦合太深,还没完全开源。
README 在 PD 分离那一行后面补了一句:大部分需要的引擎功能已经实现,只是没随这个 release 交付。这个差别值得记一下,免得把「没给」理解成「没做」。
这就像给你发动机、变速箱和一部分油路,但油箱和加油站还在 DeepSeek 机房里。你能研究它怎么省油,不能把车开走。
举三个例子。DSpark 用 draft token 加置信度调度来做投机解码,README 里给了 DEEPINFER_ENABLE_MTP_VARLEN 和 DEEPINFER_USE_NEXTN_DECODE 两个开关;SWA bounded replay 只重放一段有界后缀,减少 decoder 的 prefill 计算;EPLB 给每张卡多放几个热 expert 的副本,按最近 N 步的负载重新分配。这些是 DeepSeek 在线服务里真正省钱的部分,也是这份 release 最值得读的部分。
我不觉得这是恶意保留。2025 年那篇文档已经把顾虑写清楚了:这些部分和内部集群管理绑得太紧。但读者需要知道:你拿到的不是一个完整的 serving stack,而是一个能跑 offline inference 的核心。对想「clone 下来就上线」的人,这个差别是致命的。
再说清楚一点:offline inference 是给你喂一批 prompt、拿一批输出,适合评测和批处理;在线服务要处理并发、路由、缓存命中、故障切换。DeepInfer 的 release 把前者的核心给了,后者的两块关键组件留着。这不是文字游戏,是两种工作负载。
第三方拆解也写了同样三件事。hubwiz 的《DeepInfer 开源拆解》我能打开,它说 DeepInfer 支撑 V4.1-Flash、支持 SM100 与昇腾 950、缺 KV cache 与负载均衡;另一个 Substack 我只看到搜索摘要,摘要说它只适配一个模型和两种硬件平台。这两个都不是官方,但和我读到的一手材料对得上。把摘要当全文是不对的,所以我把这个差别也标出来。
官方在 Q&A 里还链接了一篇知乎长文,讲 KV cache 和负载均衡的内部实现。我这边打开是 403。所以那部分我只能按 Q&A 的摘要写,没读到长文。这是这篇的一个空白,我标出来。
我 clone 下来跑了构建:两个错误,和一行代码
我在 /tmp clone 了仓库,commit 9bd9cf2。
第一件事是 build。README 写的前置条件是 Linux、GCC >= 13、Python 3.12、CUDA 13。我的 Mac 一个都不满足,但我还是想看看它会在哪一步停下来。
第一次跑 bash scripts/build.sh build,报的是 python: command not found。项目脚本调用 python,这台机器只有 python3。我建了个临时 symlink,再跑,报 ModuleNotFoundError: No module named 'torch'。
这还没到 CUDA。python3 --version 是 3.8.0,项目要求 3.12;我顺手 import 了一下硬件模块,直接 AttributeError: module 'functools' has no attribute 'cache'——functools.cache 是 3.9 才有的。
两个错误都不高级。但它们说明一件事:这个仓库假设你在一台 Linux + CUDA 13 + Python 3.12 的机器上,而不是一台想试试看的 Mac。
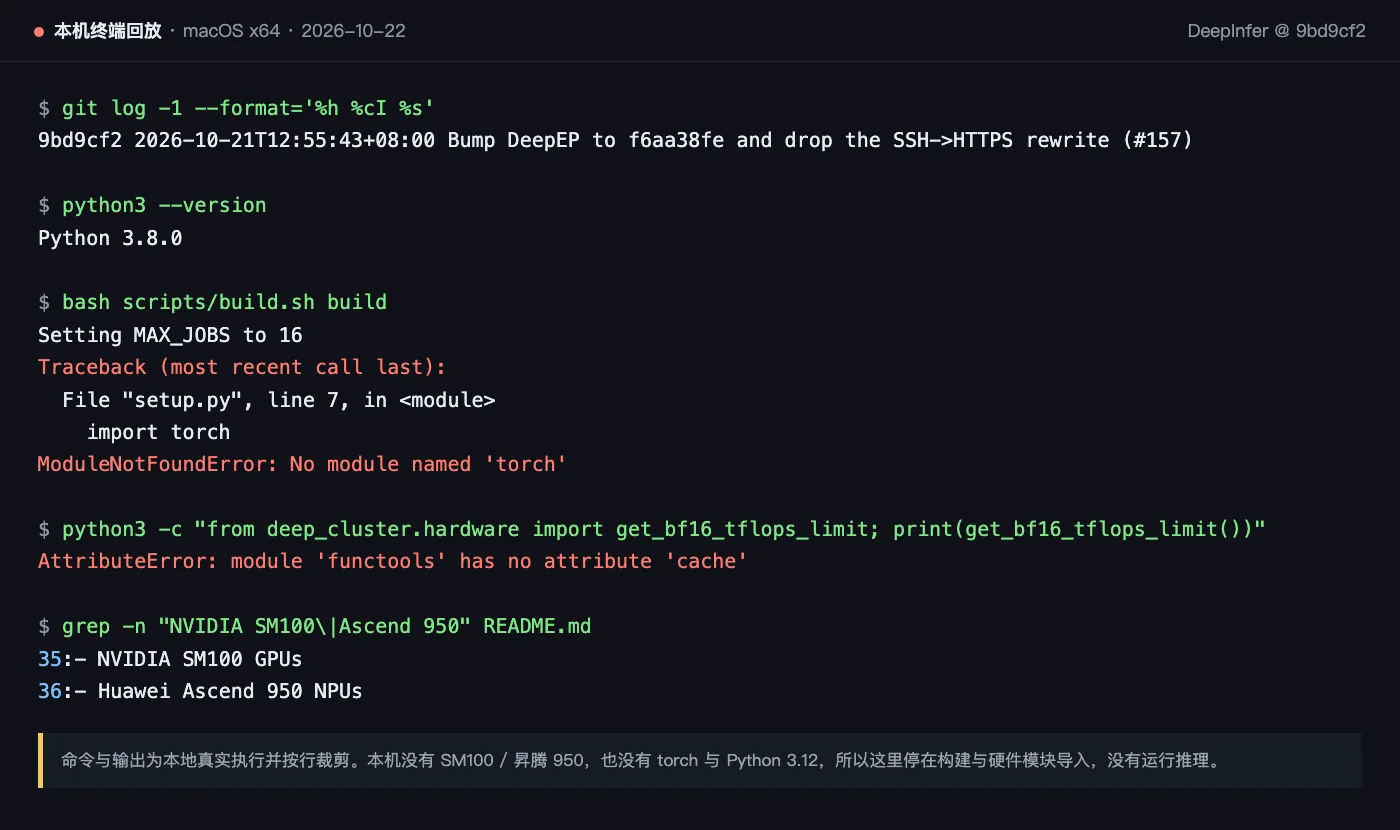
更关键的是源码里的一行判断。deep_cluster/hardware/device.py 里,is_sm_major_10() 只认 NVML 读到的 compute capability 主版本等于 10;get_bf16_tflops_limit() 在不是 Ascend、也不是 SM10 的时候,直接 raise RuntimeError("unknown GPU type")。H100 是 SM90,A100 是 SM80,都走不到这条路的正分支。
get_bf16_tflops_limit() 的返回值也不是装饰:Ascend 是 432,SM10 是 2250 或 2500,其他一律抛错。这个值会进到引擎的 roofline 计算里。换句话说,H100 不是「跑得慢」,是连这个上限都取不到。
这不是 bug,是边界。DeepInfer 没有假装自己能在 H100 上跑。
还有一个小细节:examples/offline_inference.py 的 --ep 默认是 8。连「离线跑一下」的示例都默认 8 张 GPU。你可以调小,但官方没有给单卡配置,也没有给消费级卡的路径。
我可能把「离线」理解得太乐观了。它离线的是服务形态,不是硬件门槛。
我不知道这是不是 DeepSeek 刻意的产品选择,还是 release 节奏太赶;仓库里没有路线图,我也没看到官方说「下一步支持什么」。这一点我没验到。
128 张卡只是入场券:155 万亿 token 的账没有分母
Q&A 里最容易被截屏的一句话是:「A single cluster currently serves 155 trillion tokens per day, with overall revenue of US$38 per GPU-hour (at valley pricing).」
155 万亿 token/天,单集群,$38/GPU-hour,谷时价格。三个数字都很抓人。它们是官方声称,不是我核出来的事实;我能核到的是 Q&A 原文,以及代码里那些和部署规模对得上的配置。
但这句话没有给分母:集群有多少张卡?155 万亿里输入和输出各占多少?$38 是收入还是成本?Q&A 写的是 overall revenue,不是 cost。
这两个词差得很远。收入是 DeepSeek 卖 token 收到的钱,成本是它付给 GPU、电力和机房的钱。Q&A 没有给毛利,也没有给集群规模,所以任何「每百万 token 成本多少」的推算都要先假设一堆东西。我在 HN 评论区看到有人拿 $38/卡/小时的营收和 H100 租金 $2/小时 对比,算出「利润率 1600%」;这个算法没算电力和存储,也不是会计意义上的利润率,我不能接受。
我拿 128 张卡算了一下。155 万亿 ÷ 86,400 秒 ≈ 每秒 17.9 亿 token;如果集群正好是官方说的最小高效单元 128 张卡,每张卡每秒约 1,400 万 token。这个数不能当生成吞吐读——它更像是 prefill/输入 token 的口径,或者集群远不止 128 张卡,或者两者都有。
我不是说这个数字造假。我是说它没有分母,不能拿来算你的单卡成本。
HN 评论区也在算这笔账。有人拿 OpenRouter 一周 164 万亿 token 做对照,觉得一个集群一天 155 万亿不合常理;也有人提醒,token 的口径可能不同。两边都没有官方口径,谁也说服不了谁。
官方给的门槛倒是很清楚:1P + 1D 能部署,P:D 大约 1:1;推荐的 decode 配置是 EP64 以上,所以最小高效部署单元是 64 张 prefill + 64 张 decode。
这里要抠一个字:官方说的是「smallest efficient deployment unit」,不是「minimum deployment」。同一段还写了「1P + 1D is deployable」。所以 128 张是效率门槛,不是启动门槛。我在标题里写「高效部署最低 128 张卡」,不是「必须 128 张才能跑」。这两个说法差很多,前者是官方原话,后者是我如果偷懒就会写错的结论。
这还没算存储和网络。Q&A 推荐每台 KV cache 存储服务器 20 × 30.73 TB SSD,至少 40 GB/s 读、5 GB/s 写,保留 24 小时数据;每张 GPU 约 14.4 TB 逻辑容量;跨数据中心按每 8 张 GPU 约 400 Gbps 预留。
Q&A 还给了更细的配置:prefill 用 EP2–8 / DP2–8,decode 用 EP64–128 / DP64–128,不用 TP 和 CP;KV cache 放在 3FS 上,10+2 纠删码,agent 流量 TTL 3 天、chatbot 7 天,整个存储池约 100 PiB SSD。这些数字不一定适用于你的业务,但它们说明 DeepInfer 的「省」是拿一整套基础设施换来的。
把这些加在一起,128 张卡只是入场券。
这也是我对「DeepSeek 把推理成本打下来」这个说法最保留的地方:它公开的是成本结构的一部分,不是成本本身。你能看到它怎么省,但省钱的机器、存储和网络,还在它自己机房里。
和 vLLM、SGLang 比:它不是「另一个 serving 框架」
DeepInfer 经常被拿来和 vLLM、SGLang 比。我一开始也把它当成「DeepSeek 版 vLLM」,核完发现不是。
| 维度 | DeepInfer | vLLM | SGLang |
|---|---|---|---|
| 支持模型 | 只有 DeepSeek-V4.1-Flash | 通用 LLM serving,DeepInfer 的上游 | 通用 LLM/多模态 serving |
| 硬件 | NVIDIA SM100 / 昇腾 950 | 多厂商后端(以官方文档为准) | H100/A100、AMD、TPU、昇腾 950PR/DT 等 |
| 服务完整性 | 缺 KV cache、PD 分离、跨 DP 负载均衡 | 完整 serving 栈 | 完整 serving 栈 |
| 许可证 | Apache-2.0 | Apache-2.0 | Apache-2.0 |
| 适合谁 | 有 SM100/950 集群、想复现生产栈的团队 | 大多数自建推理团队 | 需要高性能 serving、硬件多样的团队 |
这张表最重要的不是谁强,而是表格末尾那行的「适合谁」。DeepInfer 不是来替代 vLLM/SGLang 的。它更像 DeepSeek 把自己的生产配置摊开给你看:哪些 kernel 值得写、EP/DP 怎么分、EPLB 怎么调、投机解码怎么接。
还有一点容易被忽略:DeepInfer 的 README 说它「originally built primarily on vLLM」。这意味着它的很多优化是长在 vLLM 的骨架上,而不是从零写了一个新引擎。对读者来说,这是好事——你可以顺着 vLLM 的知识去读;对选型来说,这也是提醒——它不是一个独立演化的通用项目,至少现在不是。
SGLang 的 README 把硬件列得很细:H100/H200/H800、A100、AMD MI300X/MI350X、Google TPU、昇腾 950PR/DT,甚至 Apple Silicon。DeepInfer 的列表只有两行。这不是说 SGLang 一定更快,而是说它们的适用面不在一个量级。
vLLM 是它的上游,SGLang 是另一个通用答案。你要的是「在我的 H100 上把多个模型跑起来」,这两个仍然是默认选项;你要的是「看 DeepSeek 怎么把 V4.1-Flash 跑成 155 万亿 token/天」,才轮到 DeepInfer。
如果只是想把 DeepSeek 模型接进应用,最省事的仍然是 API。DeepInfer 不改变这个结论。
对四类人的影响:现在能做什么
对四类人,影响不一样。
| 人群 | 这两天的具体变化 | 现在能做什么 |
|---|---|---|
| 前端/全栈 | 没有直接影响。DeepInfer 是 Python/CUDA 服务端栈,不碰浏览器、构建链和组件库 | 别为了热点改前端选型;要做 AI 功能,继续用 API,把后端抽象留好 |
| AI 应用开发者 | 多了一个可读的生产级参考实现,但不能直接替换你的推理后端 | 读 DSpark、EPLB、structured outputs 的源码;选型表继续保留 vLLM/SGLang |
| 独立开发者 | 没有单卡/消费级 GPU 路径;构建要 Linux + CUDA 13 + Python 3.12 | 想本地跑模型,用现成的本地推理工具;把 DeepInfer 当资料,不当运行时 |
| 有集群的团队 | 如果已有 SM100 或昇腾 950,可以评估复现;否则硬件门槛过不去 | 先算 64P+64D、KV cache 存储和 400G 网络;再看缺的组件谁补 |
如果你属于前三类,这两天最该做的不是 clone,而是把自己从「DeepSeek 开源了推理框架」这句话里摘出来:它没有让你的 4090 多出一块显存,也没有让你的 API 账单变便宜。
如果你被问过「DeepSeek 都开源推理框架了,我们是不是可以自己部署,把 API 账单砍掉」,我的回答是,先看你的卡。nvidia-smi --query-gpu=compute_cap --format=csv,如果输出是 9.0、8.0,这个讨论可以到此为止;如果是 10.0,再往下算存储和网络。
前端同学也可能会在周会上听到「我们要不要自建推理降本」。你可以把这篇的结论带回去:先问卡是什么架构,再问有没有 64P+64D 和 KV cache 存储;两个问题就能把讨论从「要不要」拉回「能不能」。
如果你属于第四类,DeepInfer 值得读。不是因为它能直接上线,而是因为它把「大规模推理到底在优化什么」写成了代码:EP/DP 怎么分、EPLB 怎么统计、DSpark 怎么用 draft token、SWA 怎么 bounded replay。这些思路可以搬,代码不一定能搬。
对团队来说,最现实的动作不是立刻复现,而是把 DeepInfer 当成一份「生产栈 checklist」:你有没有 EPLB、有没有 KV cache 分层、有没有 PD 分离、有没有投机解码的置信度调度。缺哪块,先补哪块;不一定用它的代码,但可以借它的设计。
我的判断:它开源的是引擎,不是服务
我的判断:DeepInfer 开源的是引擎,不是服务。
这不是贬低。能把生产引擎的一部分开出来,已经比大多数公司做得多了。但它对开发者的实际影响,被「开源」两个字放大了。
接下来我会盯三个信号。
第一,SM90/H100 支持。不是文档里写一句「计划支持」,而是 is_sm_major_10() 被改掉,或者出现一个能在 H100 上跑通的 PR。
第二,KV cache 管理和跨 DP 负载均衡的代码真的进仓库。现在 Q&A 说得很清楚:这两块还没完全开源。如果它们进来了,DeepInfer 才从「参考实现」变成「可部署的候选」。
第三,第一个 release tag 和一份带集群规模的独立 benchmark。现在仓库是 0.1.0,没有 GitHub Release,也没有 tag,只有 commit;155 万亿 token/天的分母也没给。
这三个信号里,我最看重第二个。SM90 支持可能只是一个 PR;release tag 只是工程习惯;但 KV cache 和负载均衡是 DeepInfer 从「能跑」到「能服务」的分水岭。没有这两块,你拿到的是一台拆掉油箱的车;有了这两块,它才配和 vLLM/SGLang 放在同一张选型表里。
我的下注:如果 2027 年 1 月前这三件事都没发生,我会把「参考实现」的判断再延长半年;如果第二件先发生,我会把它加进团队选型的候选,但仍然不会推荐给单卡用户。
我可能错了。如果 1P+1D 在真实业务里能跑出可接受的延迟,128 张卡的门槛会松动;如果 DeepSeek 后续把 V3/R1 或更多模型接进来,它的适用范围也会变大。但这些我都没验到。
还有一种可能:DeepSeek 根本不打算让 DeepInfer 成为通用框架。它可能只是想给硬件伙伴和云厂商一个参考实现,让 SM100 和昇腾 950 的客户能更快把 V4.1-Flash 跑起来。如果真是这样,我拿「通用框架」的标准去要求它,本身就不公平。这个意图我没有证据,只能算猜测。
我不确定 DeepSeek 会不会把 KV cache 和负载均衡补上。如果它永远不补,DeepInfer 就只是一次性的参考发布;如果补了,今天这篇的判断会被事实修正。这也是我愿意把下注时间写到 2027 年 1 月的原因。
我把 README 关掉的时候,记住的不是 155 万亿,而是那两行 Supported hardware。它决定了这篇文章对大多数人的意义:DeepInfer 不是给你省钱的,是给你看 DeepSeek 怎么花钱的。
End of article · 读完这一篇
- 实际用时
- —
- 章节覆盖
- —
- 约读字数
- —
微信支付
支付宝