2026-10-23 晚上十点四十,我在 /tmp 里起了个不到三十行的 HTTP 服务。它不调用模型,只把收到的请求头和请求体打印到文件里。
然后把同一个请求,分别交给 Anthropic 的 Python SDK 1.17.0 和 2.2.0。
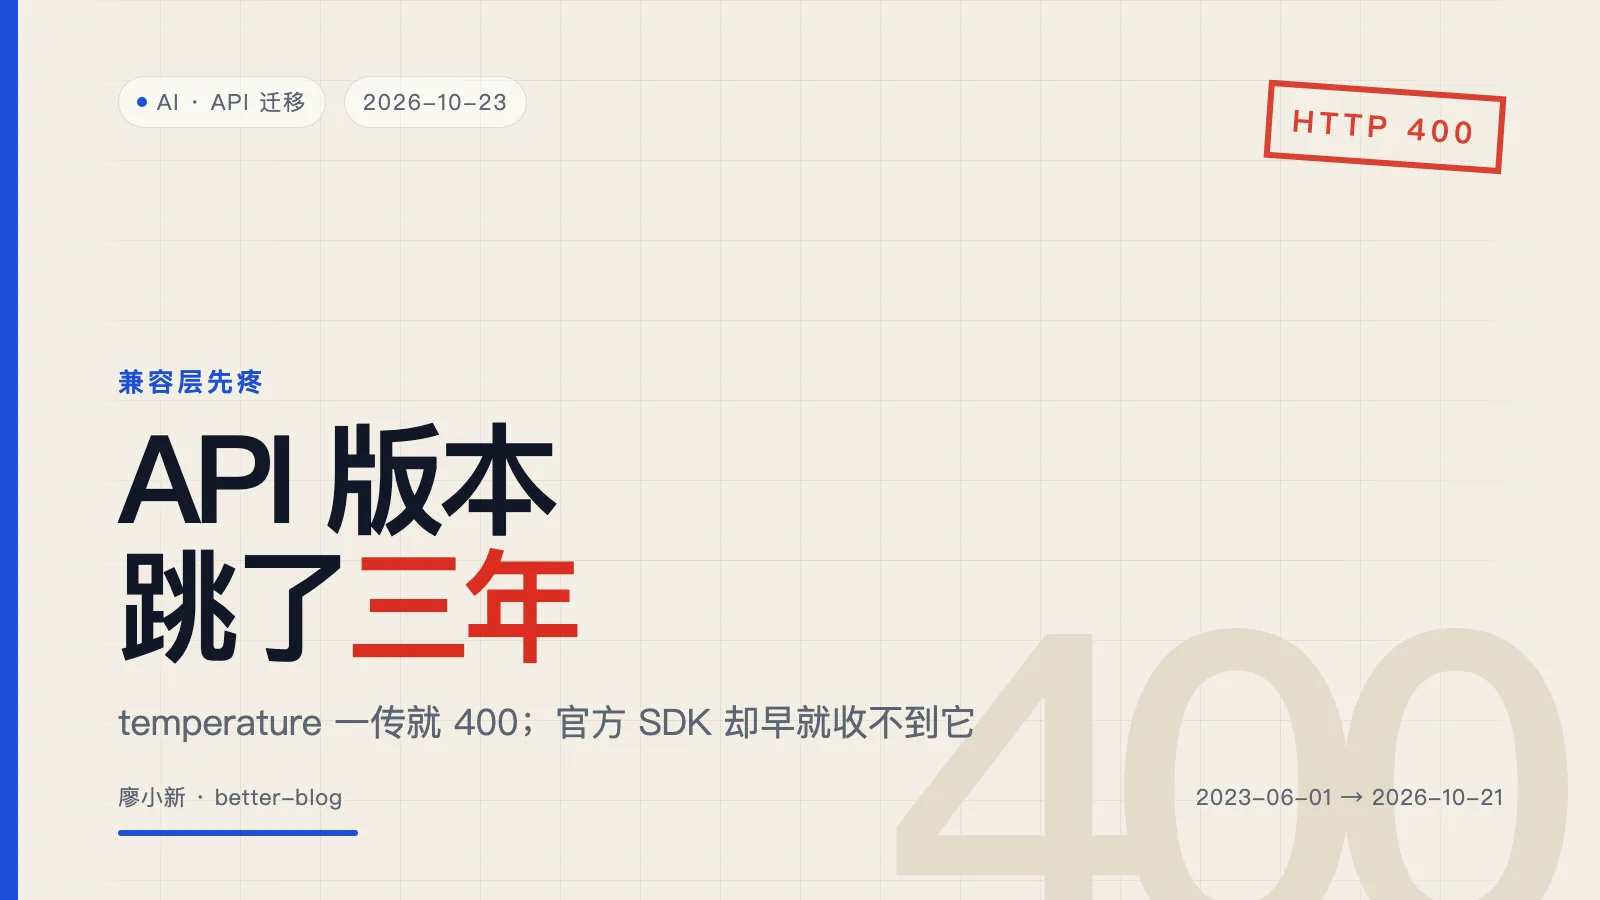
前者发出去的是 anthropic-version: 2023-06-01,后者是 2026-10-21。两行字,隔了三年。
版本号本身不吓人。吓人的是官方迁移文档里那句话:从 2026-10-21 起,请求里只要带 temperature、top_p、top_k,哪怕填的是默认值,也直接返回 400。
这篇不打算复述公告。我想回答三个问题:这次到底改了什么;我在本机验到了哪一步;以及,谁会被这个 400 真正打中。
10 月 21 日 23:51,Python SDK 的版本常量换了
先把时间线摊开。下面每一条都能在官方仓库或迁移文档里对上。
| 时间(UTC+8) | 主体 | 做了什么 | 状态 |
|---|---|---|---|
| 2026-08-21 03:58 | anthropic-sdk-python | v1.0.0 发布;从这一代起,方法签名里已经没有 temperature |
已核(迁移指南) |
| 2026-10-21 06:13 | anthropic-sdk-python | v1.17.0,最后一个 1.x;默认仍发 2023-06-01 |
已核 |
| 2026-10-21 23:51 | anthropic-sdk-python | v2.0.0;默认 API 版本切到 2026-10-21 |
已核 |
| 2026-10-22 06:00 | anthropic-sdk-python | v2.1.0 | 已核 |
| 2026-10-23 21:10 | anthropic-sdk-python | v2.2.0,新增 message threads | 已核 |
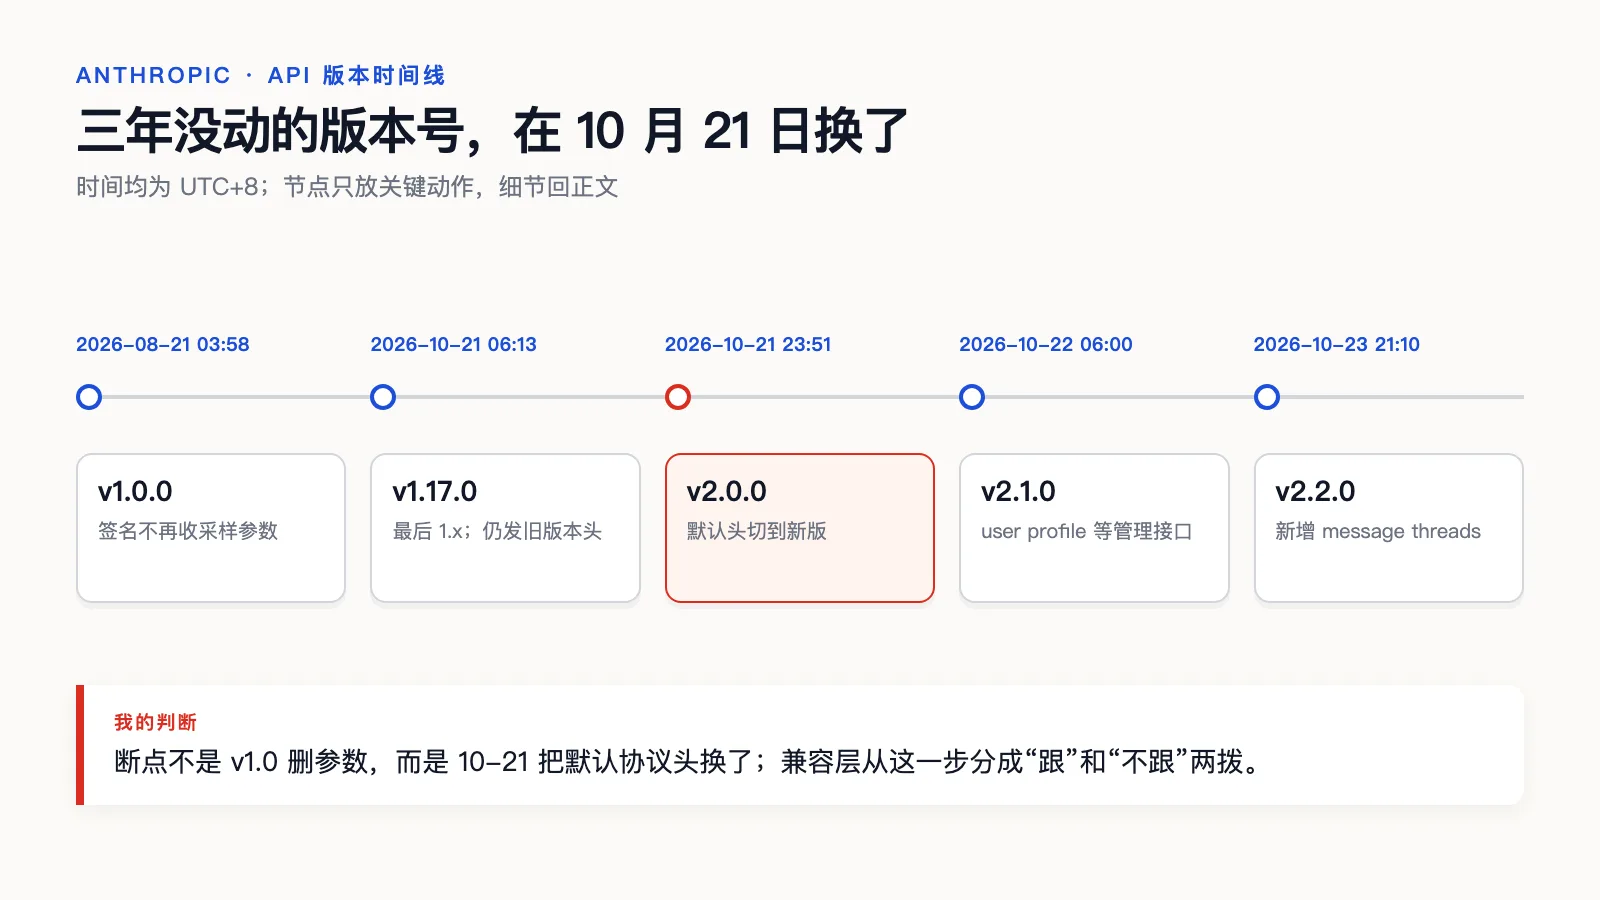
官方迁移文档的标题很直白:Migrating to API version 2026-10-21。第一段写的是,这份指南列出“从 API 版本 2023-06-01 移到 2026-10-21”要改的代码。
也就是说,中间这三年,Anthropic 的公开 API 版本号一直没动。这次是 2023 年之后第一次换。
先把“API 版本”说清楚。它不是模型版本,也不是 SDK 版本,而是请求头里的 anthropic-version。你用官方 SDK,这个头由 SDK 的常量决定;你写裸 HTTP,就得自己填。填 2023-06-01,服务端按三年前的约定解析你的 JSON;填 2026-10-21,它按新约定解析。
同一个请求体,换一个头,可能是 200,也可能是 400。这就是版本头存在的意义,也是这次迁移最容易被低估的地方:很多人以为自己只是“升了个包”,其实是在换一份协议。
我核到的一个细节是:v2.0.0 的 release note 只写了“add support for new API version 2026-10-21”,没有把删参数、改字段这些事逐条列出来。真正的变更清单在迁移文档里。只读 release note 的人,会以为这是一次普通的功能更新。
事实部分到这里:日期、版本号、默认请求头,我都核过了。至于“2023 年以来第一次”,我依据的是迁移文档自己写的起止版本,没有找到官方明确说“这是三年来首次”的句子。官方开发者账号在 X 上有一条类似表述,但那条帖子我这边打不开,所以不把它当证据。
官方 newsroom 在 2026-10-23 的列表里,也没有单独的 API 版本公告;最近的条目是 10-23 的 Agent Skills 捐赠和 10-21 的信托人事。公告落在文档和开发者账号,这大概解释了为什么不少人直到 SDK 发版才发现。
还有一个不太体面的细节:Anthropic 的官方文档站在我这边会被跳到地区限制页。curl 返回 200,内容却是 app-unavailable-in-region。我实际读的是官方文档的一个 GitHub 镜像仓库,并拿 Anthropic 官方 SDK 仓库里的 MIGRATION.md 交叉确认了链接和版本号。原文措辞我尽量逐字引,但你要说“我打开了官方域名”,没有。
三条会直接回 400 的 Messages 变更
这次不是加一个 beta 头就能绕过去的小改。迁移文档把三条 Messages API 变更列在“Breaking changes”下面,触发条件都很具体。
| 变更 | 什么请求会中招 | 怎么改 |
|---|---|---|
| 采样参数被移除 | Messages 请求或 Message Batch 请求里带 temperature、top_p、top_k,默认值也不行 |
删掉;旧模型确实需要时,只能把请求留在 2023-06-01 |
| user 消息里的 citations 被拒 | user 消息的 text block 带非空 citations,包括 search_result 里面 |
去掉这些 block 的 citations |
| assistant 消息里的 document 块被拒 | 直接把 document block 放在 assistant 消息里 |
把文档放进 user 消息;嵌套在工具结果里的仍可用 |
采样参数这条最狠。文档的原话是:2026-10-21 里,发送这三个参数的请求会返回 400,即使传的是参数的默认值。
它还补了一句容易被忽略的后果:不带这些参数时,请求按默认值采样,包括 temperature 为 1.0;对 Claude Sonnet 4.6 这类还能接受其他值的模型,原来靠调低 temperature 换稳定输出的做法,效果没有了,而且没有替代设置。
这句话对做结构化抽取、分类、评测的人影响最大。以前大家把 temperature: 0 当成“尽量确定性”的开关。现在在新版本上,这个开关不是失效,是直接把请求打回去。
我在这儿要收一下:400 是官方声称,我没有真的打到 API。 本机没有可用的 Anthropic key,付费调用我也不跑。所以我能证明的是“SDK 会发什么”,不能证明“服务端一定回什么”。这两件事在我这里必须分开。
这两层错误也不一样。SDK 签名层是本地错误:你多传一个参数,Python 在发请求之前就抛 TypeError,连网络都不会出。API 版本层是服务端错误:请求发出去了,服务端读完 JSON,发现这个版本不认这个字段,回你 400。
前者好查,堆栈直接指到你那一行代码。后者难查,因为错误发生在别人的服务器上,你的日志里只有一个状态码和一段错误消息。如果网关还把上游的 400 包装成 500,你连“是参数问题”都看不出来。
所以这次迁移最该先做的不是升级,是搞清楚自己的请求到底经过了哪几层。
边界再补一条:这些变更不只打在 POST /v1/messages。token 计数和 Message Batch 的每个请求也走同一套规则,只要那个 batch 是用 2026-10-21 创建的。在线请求改完了,离线批处理可能还在用旧格式,第一次跑新 batch 才会炸。
我在本机截了两个 SDK 的请求头
复现环境不复杂:macOS,Python 3.12,用 uv 建了两个虚拟环境,分别装 anthropic==1.17.0 和 anthropic==2.2.0。再起一个本地 HTTP 服务,把请求头和 JSON body 原样写进日志。
第一次装就翻车了。系统自带的 python3 是 3.8,而 1.x 和 2.x 都要求 3.10 以上,pip 报的是“找不到匹配版本”。我盯着那串从 0.2.2 排到 0.72.0 的版本列表看了半分钟,才反应过来不是网络问题,是解释器太老。换成 3.12 之后一次就装上了。
这个本地服务会返回一个最小的 Messages 响应,所以 SDK 能正常走完解析,不会因为响应格式不对提前抛错。我要看的不是模型输出,是请求离开本机之前长什么样。
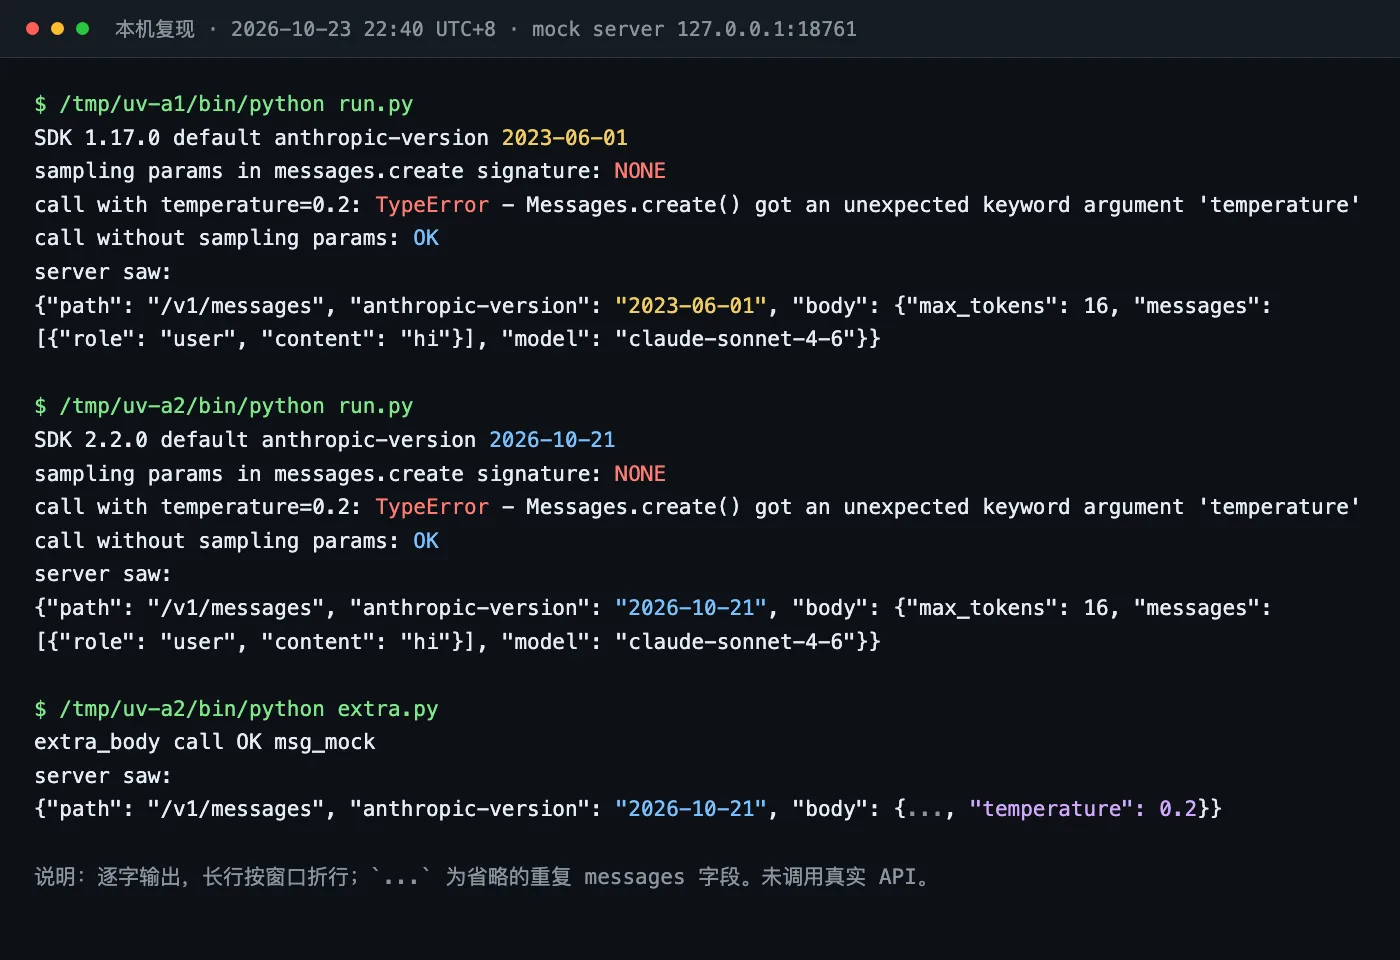
结果如下,都是本机 2026-10-23 22:40 前后的真实输出:
SDK 1.17.0 default anthropic-version 2023-06-01
sampling params in messages.create signature: NONE
call with temperature=0.2: TypeError - Messages.create() got an unexpected keyword argument 'temperature'
call without sampling params: OK
server saw: {"anthropic-version": "2023-06-01", "body": {"max_tokens": 16, "messages": [...], "model": "claude-sonnet-4-6"}}

SDK 2.2.0 default anthropic-version 2026-10-21
sampling params in messages.create signature: NONE
call with temperature=0.2: TypeError - Messages.create() got an unexpected keyword argument 'temperature'
call without sampling params: OK
server saw: {"anthropic-version": "2026-10-21", "body": {"max_tokens": 16, "messages": [...], "model": "claude-sonnet-4-6"}}
这里有个和我预想相反的地方。
我原本以为,temperature 是在 2.0 这次大版本才从 Python SDK 里删掉的,所以“锁在 1.x 就安全”。实际测完发现,1.16.0 和 1.17.0 的 messages.create 签名里也早就没有它了。再往上查,v1.0.0 发布于 2026-08-21 03:58(UTC+8),从那一代起就已经不收这三个参数。
所以我最初那版判断是错的:这次大版本并没有突然删掉 Python SDK 的 temperature,它只是把默认请求头换成了新版本。 SDK 层面的“删参数”已经发生了两个月。
那为什么还会有人被打中?
因为 SDK 留了一扇后门:extra_body。迁移文档明确写了,如果旧模型还需要采样设置,可以用 extra_body={"temperature": 0.2},这个字典会被原样合并进请求 JSON。
我试了。2.2.0 加上 extra_body 后,本地服务收到的是:
{"anthropic-version": "2026-10-21", "body": {..., "temperature": 0.2}}
头部是新版本,body 里有 temperature。按官方文档,这正是会返回 400 的组合。SDK 不会在本地拦你,它把这颗子弹原样递出去。
TypeScript 那边我也顺手看了一眼。@anthropic-ai/sdk@1.1.0 的 messages.d.ts 里,temperature 出现 0 次。两个 SDK 在签名层是一致的:都不给你这个参数。Python SDK 还留了 extra_body 这个逃生口。
被 400 打中的,是夹在中间的兼容层
把人群拆开看,结论会清楚很多。不是所有用 Claude 的人都要今天动手。
| 你属于哪类 | 会不会被 400 打中 | 现在最该做的一件事 |
|---|---|---|
用官方 Python/TS SDK、留在 1.x 或 2023-06-01 |
不会立刻;升级 2.x 才会换版本头 | 先查 extra_body 里有没有 sampling 参数 |
| 裸 HTTP、curl、自研网关 | 会,只要你照旧发 temperature |
显式选版本:要么删参数升新版,要么钉住旧版 |
| LLM 兼容层(LiteLLM 这类) | 看实现:写死旧版本头的暂时不会,但也被锁在旧版本 | 建一张“模型 → 版本头”的映射表 |
| 读 Admin API / Analytics 的后台 | 不一定是 400,但旧字段会读不到 | 按新字段名改脚本和看板 |
| Bedrock 上的老模型 | 新版本不可用 | 留在旧 SDK,或先换到 Claude 4.7+ |
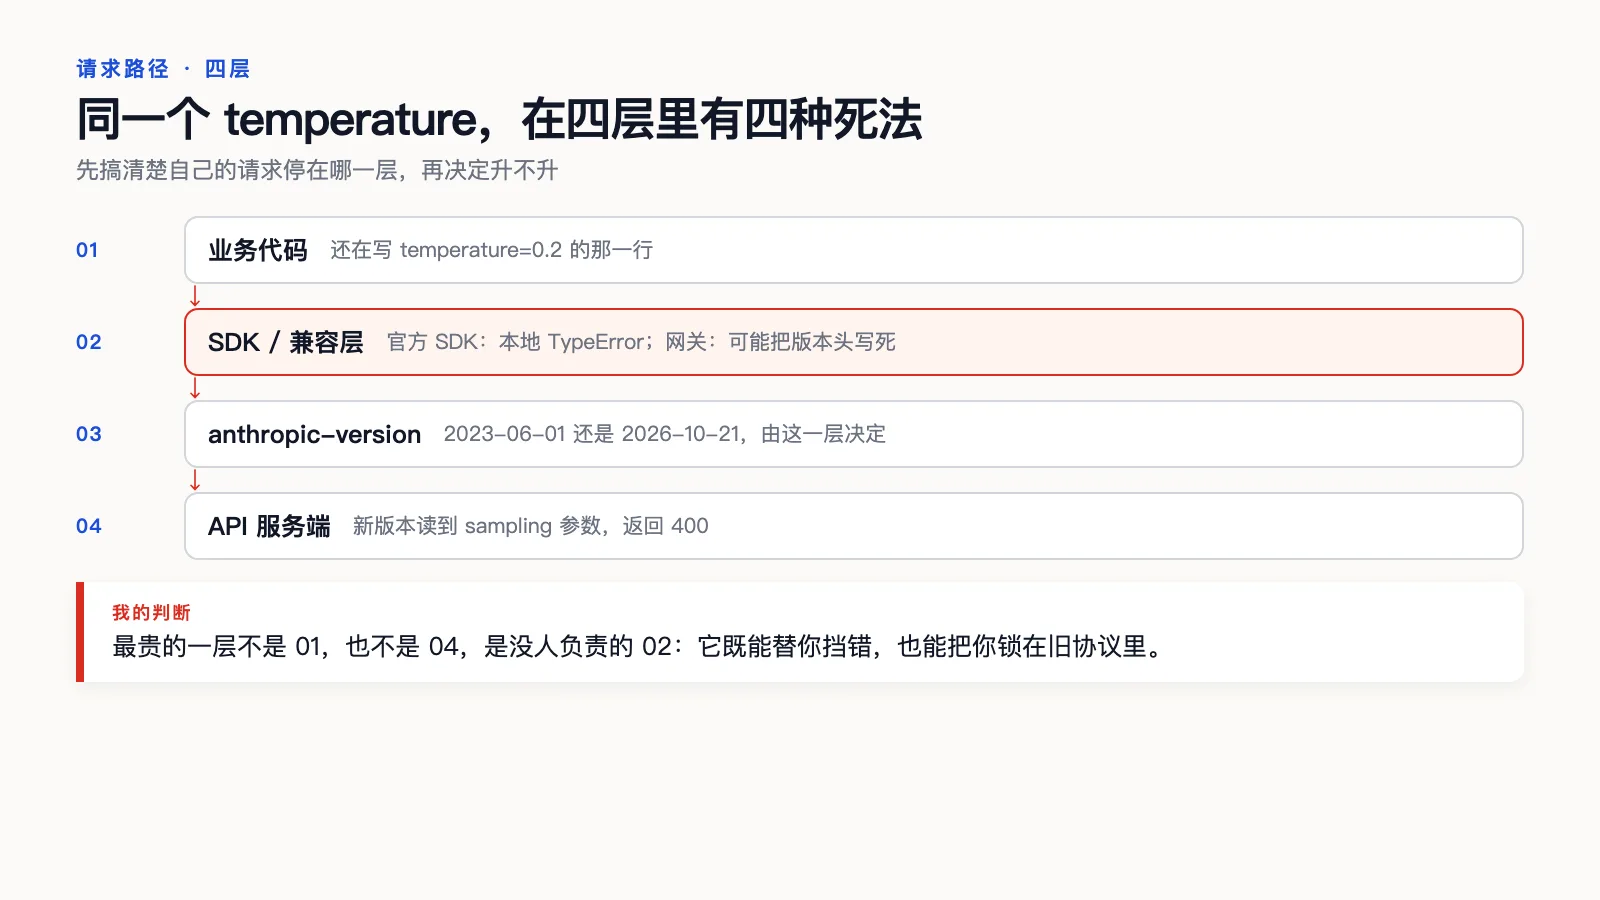
有三类人可以先不动。
第一类,Bedrock 上跑 Claude 4.7 之前模型的。新版本对你们不可用,升级 SDK 只会让自己同时面对两套边界,收益为零。
第二类,评测集强依赖低 temperature 的。新版本没有替代设置,这不是“改个参数”能解决的,先想清楚输出波动能不能接受,再谈迁移。
第三类,网关版本头写死、且短期内没有新模型需求的。你们不会 400,也不会拿到新行为;先把版本头改成配置项,比仓促升级更值。
LiteLLM 是个很好的样本。我 2026-10-23 晚上看了它的仓库:主 Anthropic 适配器、Azure AI 的 Anthropic 适配器、DeepSeek 的 Messages 适配器,都把 anthropic-version 写死成 2023-06-01;代码搜索里,Rust 版的常量也是同一个值。
这意味着两件事。
第一,大量通过 LiteLLM 调 Claude 的应用,不会因为这次变更突然 400。兼容层替你挡住了。
第二,它们也拿不到 2026-10-21 的行为。版本头是写死的,模型能换,协议不会自己往前走。
这就是“兼容层”的代价:它让上层代码不用改,也让上层代码永远慢一拍。平时这是优点,协议换代时,它变成账单。
Admin API 那条更隐蔽。它不是 400,是字段悄悄换名:roles 变 role_ids、group_id 变 rbac_group_id、name 变 display_name、group_type 变 group.type、API key 上的 workspace_id 变 scope;Analytics 里 actor.email 变 actor.email_address、summaries 变 data。
读这些字段的看板、成本脚本、权限同步任务,不会在请求时炸。它们会在某天早上显示一张空表,或者把所有人都算成“无 workspace”。
这类变更不会出现在 400 的统计里,所以最容易漏。把 Admin 字段的读取也放进同一次迁移清单,别等看板空了才回头找。
八个客户端一起跳大版本,Bedrock 还留了一道门
这次不是只有 Python 动。迁移文档给出的“第一个使用 2026-10-21 的版本”是一张跨语言清单:
- Python
anthropic2.0.0 - TypeScript
@anthropic-ai/sdk1.0.0 - Go SDK 2.0.0,模块路径改成
/v2 - Java
com.anthropic:anthropic-java3.0.0 - C#
Anthropic13.0.0 - Ruby gem 2.0.0
- PHP SDK 1.0.0
- CLI
ant2.0.0,Go 安装路径同样要加/v2
八个客户端同时跳大版本,这件事本身就说明它不是“加个参数”。如果只是加功能,没必要让所有语言的模块路径和主版本一起动。
跨语言大版本的成本不在代码量,在协调。Go 的模块路径加了 /v2,旧 import 会继续装 v1,而且不报错;C# 从 12 直接跳到 13;PHP 只跑 composer update 还会留在旧约束里。每一门语言都有一个“看起来升级了、其实没有”的坑。
还有一道门:Amazon Bedrock 上,2026-10-21 只对 Claude 4.7 及更新模型可用。老模型要么继续用现在的 SDK,要么继续发旧版本头;想用新版本,得先把模型换到 4.7 以上。
这条对我的读者很实际。很多团队不是直连 Anthropic,而是走 Bedrock 或云厂商的托管通道。你的代码升了 2.x,模型还在老版本,请求会被版本边界挡住。迁移顺序必须是“先换模型,再换协议”,不是反过来。
SDK 内部还有两类改动,容易被“我只用 messages.create”的人忽略。
一类是 MessageParam 从单一类型变成按角色拆开的联合类型。Python 里以前可以写 MessageParam(role="user", content="..."),现在这样调用会抛 TypeError,要改成 dict;TypeScript 里 interface X extends MessageParam 也不再合法,得改成类型别名。请求发出去的 JSON 没变,变的是你的类型体操。
另一类是 output_format 让位给 output_config。结构化输出的 schema 字典不再走 output_format=,要走 output_config={"format": {...}};output_format= 只接受类型(比如 Pydantic 模型或 TS 类型)。
这两类不会让线上立刻挂,但会让 mypy、pyright、tsc 红一片。如果你把类型检查放在 CI 里,它们会替你提前发现大部分迁移点。这也是我建议先升 SDK、先让类型检查跑一遍,再动线上流量的原因。
半天能做完的迁移:三条 grep 和一次金丝雀
如果你只是用官方 SDK 调当前模型,迁移量可能比想象中小。真正花时间的是找那些“不在 SDK 里”的调用。
先跑三条搜索,范围包括业务代码、网关配置、部署脚本和文档示例:
# 1) 谁还在发采样参数
grep -rnE '\b(temperature|top_p|top_k)\b' --include='*.py' --include='*.ts' --include='*.js' --include='*.go' --include='*.yaml' .

# 2) 谁在显式设置 API 版本
grep -rn 'anthropic-version' .

# 3) 谁在读旧 Admin 字段
grep -rnE '\b(role_ids|rbac_group_id|display_name|group\.type|actor\.email_address)\b|workspace_id|summaries' --include='*.py' --include='*.ts' --include='*.sql' .
第一条的结果要分两类看:走官方 SDK 的,temperature= 早就编译不过,能搜到的大多是 extra_body、裸 HTTP、或者别的语言的客户端;走兼容层的,看它有没有把参数透传下去。
第二条决定你会不会真的收到 400。写死 2023-06-01 的,短期安全,长期落后;写死 2026-10-21 的,必须把第一条清干净;从客户端透传的,最危险,因为版本头和参数可能来自两个不同年代。
第三条不是 400 问题,是数据问题。先改读取方,再改写入方,别反过来。
搜完会得到三个很常见的误读,先在这儿拆掉。
误读一:升到 2.x 才会删参数。 不对。Python SDK 从 2026-08-21 的 1.0.0 起就不收 temperature 了;2.x 换的是默认 API 版本。
误读二:不传参数就等于回到旧行为。 不对。新版本的默认采样包括 temperature 1.0;旧版本上你显式调低的值,在新版本上没有等价物。
误读三:版本头只是 SDK 的事。 不对。裸 HTTP、网关、云厂商托管通道都会自己设这个头;SDK 升级不会替你改它们。
然后做一次金丝雀。不要全量切。挑一条低风险链路,把 anthropic-version 显式设成 2026-10-21,跑 5% 流量,盯三件事:400 的比例、错误信息里的参数名、以及响应内容有没有因为默认 temperature=1.0 变得飘。
金丝雀还要准备回滚。把 SDK 版本和版本头都做成可回退的配置:SDK 用 lockfile 钉住,版本头用环境变量控制,别让两者绑死。出问题时,你要能只退回其中一个。
测试里最值钱的一条断言,不是“请求成功”,是“请求体里没有 sampling 字段”。前者只能证明这一次没炸,后者能防止下一个人把参数加回来。用 mock server 把 body 落盘,在 CI 里 diff 一次,比读迁移文档更可靠。
按人群给三条具体动作:
- 前端/全栈:如果你在 Next.js 的 route handler 里直接调 SDK,先在本地升 SDK、跑
tsc,把MessageParam的联合类型和output_config改完;线上先留旧 SDK,或者显式钉住2023-06-01,再切流量。 - AI 应用/Agent 开发者:重点查工具调用前后的消息构造。
assistant消息里塞document、user消息里带citations,这两类在新版本都会 400;评测集里如果靠temperature=0保稳定,要准备接受输出波动。 - 独立开发者/小团队:如果你用 LiteLLM 这类兼容层,先确认它写的版本头,不要假设“升级模型就等于升级协议”;如果你自己维护网关,把版本头做成配置项,不要写死在代码里。
这不是 temperature 之死,是兼容层时代的结束
我的判断分两层。
短期:不要因为看到“首个正式版本”就全量升 2.x。官方 SDK 用户的大部分代码不会挂,但 extra_body、裸 HTTP、Admin 字段这三处会给你惊喜。先盘点,再金丝雀,再全量。
长期:这次真正变化的不是 temperature 这个参数,而是“协议版本”重新变成了一个需要被管理的依赖。过去三年,2023-06-01 像空气一样存在,没人需要想它。现在它有了一个继任者,兼容层里那些写死的字符串,会一个个变成技术债。
我下个注:两周内,至少一个主流 LLM 网关会发布针对 2026-10-21 的显式支持,或者至少把版本头改成可配置;如果两周过去,大家还在装死,那我“兼容层是瓶颈”的判断就错了,真正的瓶颈会回到应用代码。
另一个可检验的信号是 sunset 日期。截至 2026-10-23,我在迁移文档里没看到 Anthropic 给 2023-06-01 设定停止支持的日期。这一点我没验到,也可能是我看漏了。 如果官方随后公布一个明确的时间点,这件事的优先级就要整体前移。
什么会让我改口:如果 Anthropic 给 sampling 参数加回一个兼容开关,或者 Bedrock 把 2026-10-21 下放到 Claude 4.6,那这次迁移的紧迫性就会下降。前者说明他们听到了生态的抱怨,后者说明云通道的节奏比官方慢半拍。
回到开头那两行请求头。
2023-06-01 和 2026-10-21 之间,隔的不是三年时间,是一层没人愿意维护、但所有人都依赖的兼容代码。版本号只是把它照出来了。
我核过的链接:
- Anthropic 迁移指南(官方;我这边直连会被跳到地区限制页)
- anthropic-sdk-python MIGRATION.md
- anthropic-sdk-python v2.0.0
- cellcog 的第三方整理(2026-10-21)
- LiteLLM 仓库(把
anthropic-version写死的适配器在这里)
End of article · 读完这一篇
- 实际用时
- —
- 章节覆盖
- —
- 约读字数
- —
微信支付
支付宝