10 月 17 日下午 16:27,OpenRouter 的模型列表里多了一行 DeepSeek V4.1 Flash 1017。往前推 21 分钟,ModelScope 上同名模型卡的最后更新时间停在 16:06。DeepSeek 自己的 news 页只写了日期 2026/10/17,没有小时。
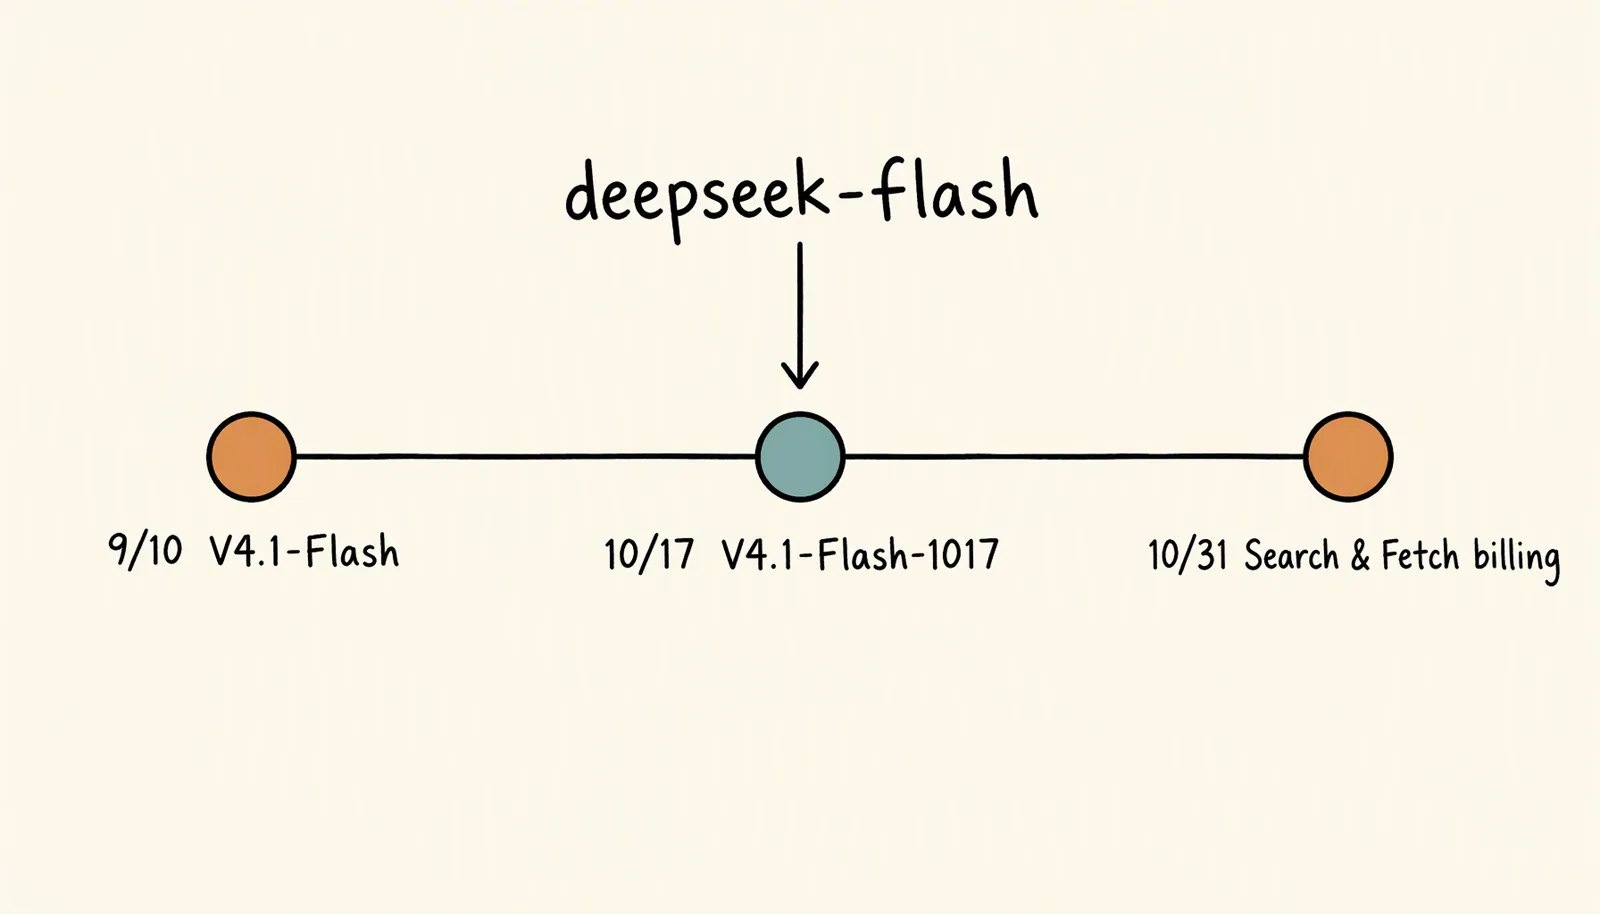
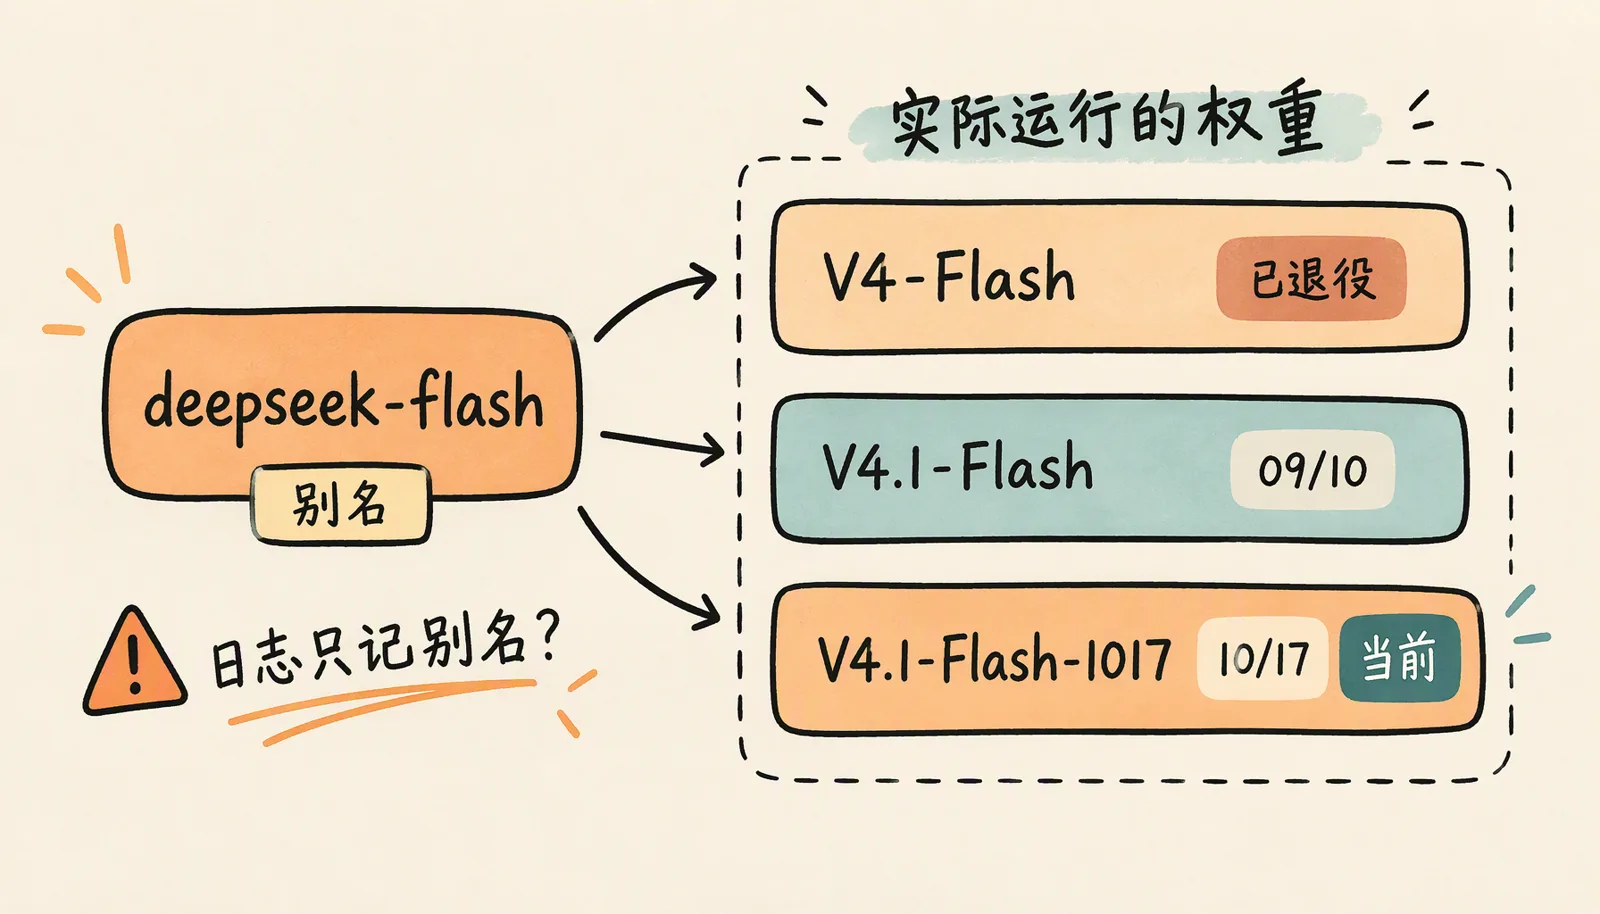
我盯着这几个时间点看了一会儿,才意识到这次最别扭的地方不是新模型,而是名字。你代码里写的 deepseek-flash 没有变,官方价格表的模型版本已经换成 DeepSeek-V4.1-Flash-1017;连 deepseek-v4-flash 这个旧名也照收,只是后面的旧模型退役了,请求会被新模型接走。
三个名字,一层套一层
先把三个名字摆清楚。
| 名字 | 现在是什么 | 你该怎么看 |
|---|---|---|
deepseek-flash |
当前推荐模型名,模型版本是 DeepSeek-V4.1-Flash-1017 |
接口名,不是权重版本 |
deepseek-v4-flash |
旧名,仍被接收;对应模型已退役,请求由 1017 接走 | 兼容层,不是旧模型 |
DeepSeek-V4.1-Flash-1017 |
这次实际的模型版本 | 文档里的版本号,不是可指定的 API 名 |
官方价格页的脚注写得很直白:The legacy names deepseek-v4-flash and deepseek-v4-flash-vision-exp are still accepted, but the corresponding models have been retired, their requests are served by the DeepSeek-V4.1-Flash-1017 model and billed at the Flash price.(来源:DeepSeek 价格页,2026-10-17 抓取)
我一开始以为 DeepSeek 会给新快照单独一个 model 名,翻到这条脚注才发现不是。说白了,deepseek-flash 现在是一条滚动通道,不是一个权重版本。
旧代码不会报错,但它拿到的已经不是昨天那个模型了。
时间线:10 月 17 日一天里改了什么
| 时间(北京时间) | 发生了什么 | 来源 |
|---|---|---|
| 10-17 10:41:50 | ModelScope 创建 V4.1-Flash-1017 模型卡 | ModelScope 元数据 |
| 10-17 16:06:25 | 模型卡最后更新(484.6B、MIT、1M 上下文) | ModelScope |
| 10-17 16:27:04 | OpenRouter 上架,canonical_slug 带 20261017 |
OpenRouter |
| 10-17(只标日期) | DeepSeek news 与价格页改为新版本 | api-docs.deepseek.com |
时间线里最值得记的是 16:27 这个点:第三方聚合器比官方 news 页更早给出可机器读取的日期快照。官方页只写到天,所以“几点发布”这件事,严格说我没法从一手来源确认;上面表里的时分来自 ModelScope 和 OpenRouter 的元数据,不是 DeepSeek 的公告。
这不是挑刺。做回归的时候,你总得知道该拿哪个时间点之前的输出当基线。
旧别名还收,但旧模型已经退役
这次更新最容易被忽略的一句话,是“still accepted”。它听起来像兼容,实际是把兼容层做在了路由上:名字还认,后面的模型换了。
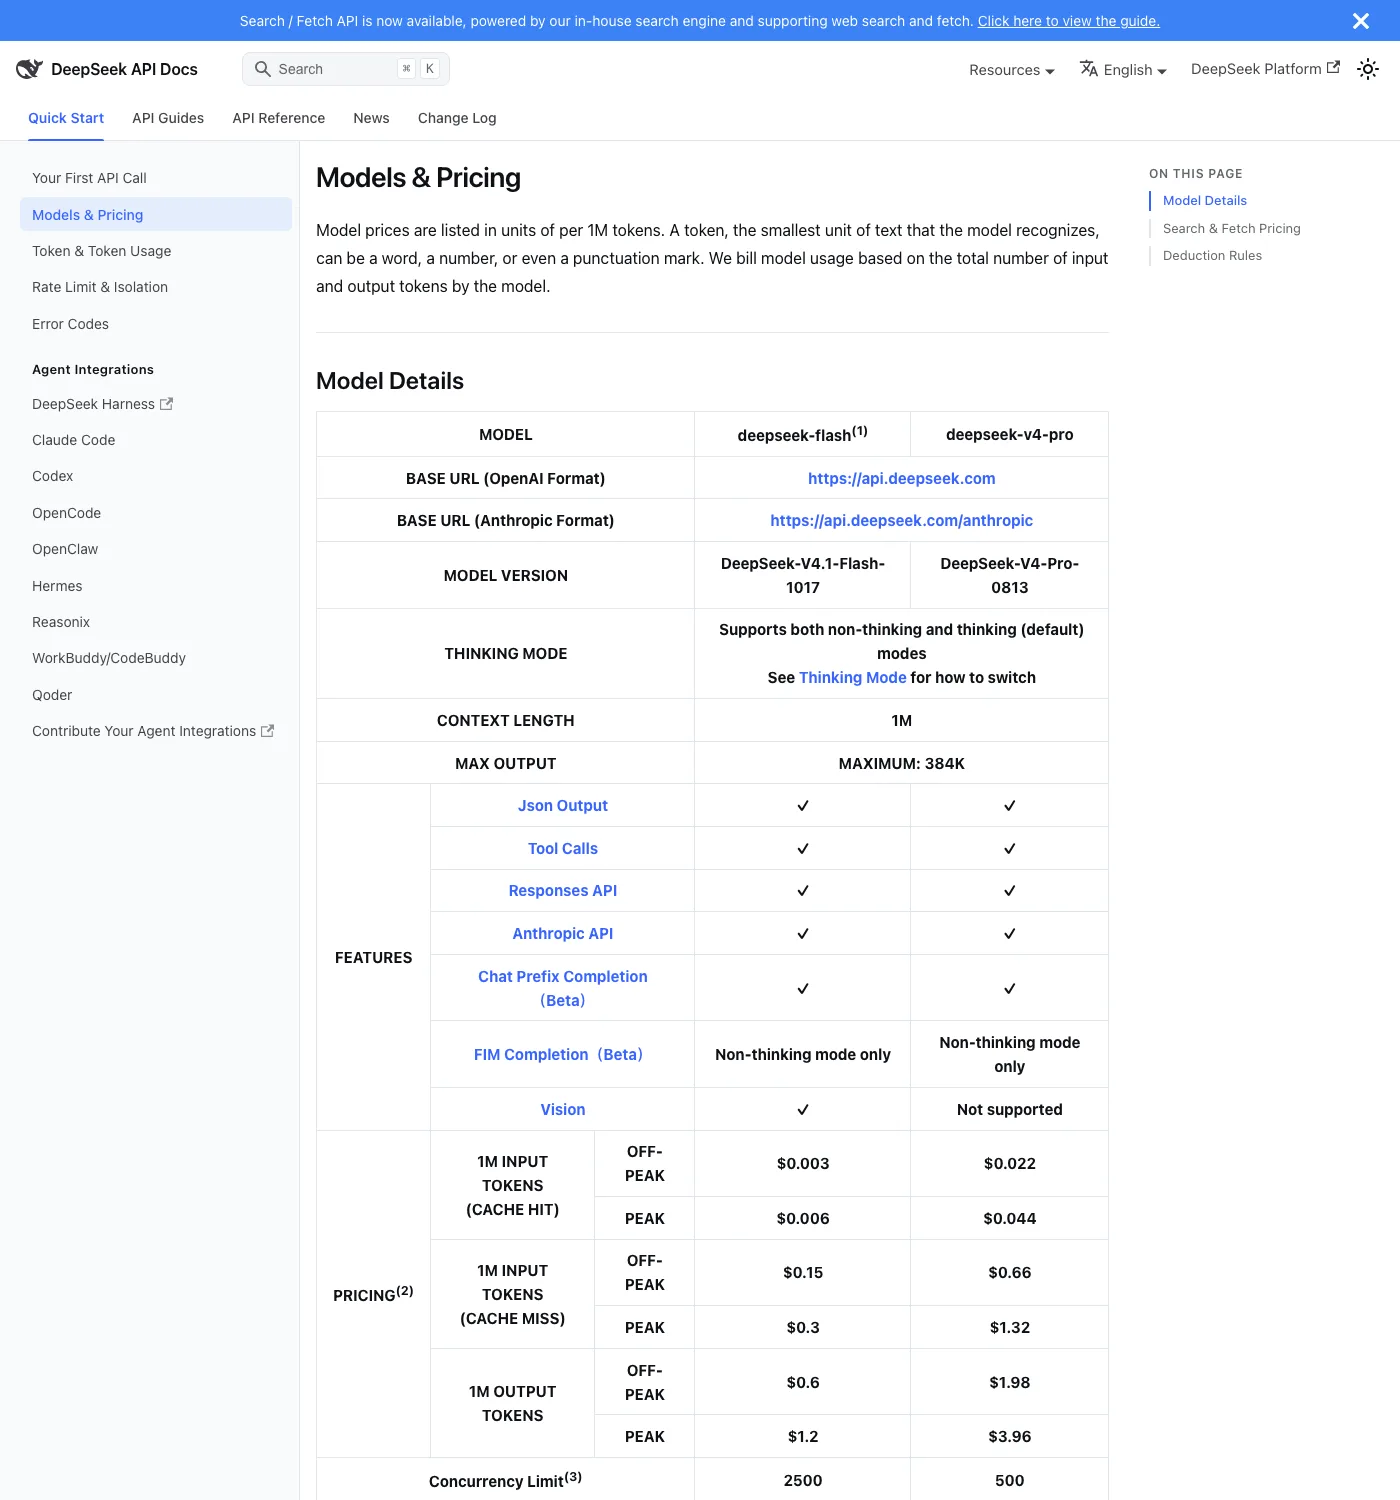
对业务代码,这是好事。你不用改一行调用,模型就升级了,vision、1M 上下文、384K 最大输出也都还在。官方价格页把 deepseek-flash 的能力列得很清楚:CONTEXT LENGTH 1M、MAX OUTPUT MAXIMUM: 384K、THINKING MODE Supports both non-thinking and thinking (default) modes、Vision ✓。
对需要可复现的团队,这是另一回事。
我没拿到 DeepSeek 的 key,所以没法实测响应里的 model 字段到底返回别名还是版本号;文档在价格页也没有给出一个可以指定的日期快照名。OpenRouter 那边倒是给了 deepseek/deepseek-v4.1-flash-20261017 这样的 canonical_slug,但它是聚合器的命名,能不能长期钉住旧快照,我没验到。
模型卡里还有一个给自托管的人看的细节:This release does not include a Jinja-format chat template. 官方补了 encoding/encoding.py 和 deepseek-recipe,但这意味着你不能假设 tokenizer_config.json 里躺着一个现成的 chat template。想把 MIT 权重接进现有推理栈,先看这一条。
我这边 Hugging Face 的 API 是连接失败(HTTP 000),ModelScope 能打开;所以权重细节我只核到模型卡的公开元数据(484.6B 参数、MIT 许可、last_updated 2026-10-17),没有下载权重,也没有跑推理。
官方没有解释为什么不另起一个名字。从结果看,旧名保留让调用方不至于断掉;代价是版本信息被折叠进了一个不会变的字符串里。
这就是滚动别名的代价:接口稳定了,版本证据反而更少了。
价格表里的昼夜开关:同一百万 token,白天贵一倍
价格页还有一条比模型版本更直接影响账单的规则:非高峰价格是高峰的一半。
| 项目 | 非高峰 | 高峰 |
|---|---|---|
| 输入(缓存命中)/ 1M tokens | $0.003 | $0.006 |
| 输入(缓存未命中)/ 1M tokens | $0.15 | $0.30 |
| 输出 / 1M tokens | $0.60 | $1.20 |
高峰时段是 UTC 01:00–04:00 和 06:00–10:00,周一到周五,排除中国法定节假日;换成北京时间就是 09:00–12:00 和 14:00–18:00。其余时间都算非高峰,周末和法定节假日全天非高峰。
拿一个具体任务算:1M 输入(缓存未命中)加 200K 输出,非高峰是 0.15 + 0.2 × 0.60 = 0.27 美元,高峰是 0.30 + 0.2 × 1.20 = 0.54 美元。同样的 token,账单差一倍。
如果输入命中缓存,非高峰的输入成本只有 $0.003,输出仍然按 $0.60 算。所以省钱的顺序是:先把能缓存的上下文缓存住,再考虑把任务挪到非高峰。
这是按官方单价算的,不是我的真实账单。但结论够清楚:如果你有批量任务,调度器比模型选型更能省钱。能挪到晚上或周末跑的,别留在工作日下午。
Search 和 Fetch 开放:按次计费,免费窗口到 10 月 31 日
同一天的 news 页还有第二件事:DeepSeek 把 Search 和 Fetch 做成了独立 API,开放给所有人。
端点是 POST https://api.deepseek.com/v1/tools/search 和 POST https://api.deepseek.com/v1/tools/fetch,走同一套 Bearer 鉴权,返回原始 JSON。Search 返回网页结果,Fetch 把单个网页转成 Markdown。
Search 的 count 默认 10、最多 50,查询里可以用 site:、lang:、after: 这些操作符;Fetch 只取单个页面,返回 Markdown。
价格是每个端点 $0.75 per 1,000 calls,按成功请求计费。通过 DeepSeek Harness、Claude Code、Codex 里的服务端工具调用目前免费,计费从 2026-10-31 16:00 UTC 开始——也就是北京时间 11 月 1 日 0 点。
按官方单价算:一个任务平均 10 次检索,1 万个任务就是 10 万次调用,75 美元,不含模型 token。这个数字不大,但它会跟着 agent 的步数线性涨。
免费窗口只有两周多。如果你打算把 Search/Fetch 接进生产,别把“现在免费”写进成本模型。
工具调用按次收费之后,agent 的循环次数就不只是延迟问题,也是账单问题。
我核了什么,哪里没验到
我核过的:
- DeepSeek news 页与价格页均返回 200;模型版本、上下文、输出上限、价格、旧别名脚注都是逐字从页面取的。
- ModelScope 模型卡返回 200,元数据是 484.6B 参数、MIT 许可、last_updated 2026-10-17;模型卡自己写了不含 Jinja chat template。
- OpenRouter 的模型列表返回 200,
context_length是 1048576,输入/输出价格与 DeepSeek 官方页一致,canonical_slug 带20261017。 - 不带 key 请求
https://api.deepseek.com/models返回 401,响应体是Authentication Fails (governor)。这只证明端点在、需要鉴权。
我没验到的:
- 没有 key,没有实际调用
deepseek-flash或旧别名,所以旧别名是不是真的路由到 1017、vision 和 1M 上下文实际表现如何,我都不知道。 - 没有跑第三方或自建 benchmark。官方说的 “Pareto improvement” 是厂商声称,我没有复现。
- Hugging Face 打不开,权重文件没下,模型卡只看了 ModelScope 的版本。
- OpenAI 的 platform changelog 返回 403,下面那条 OpenAI 短讯只核到 GitHub 的 SDK release。
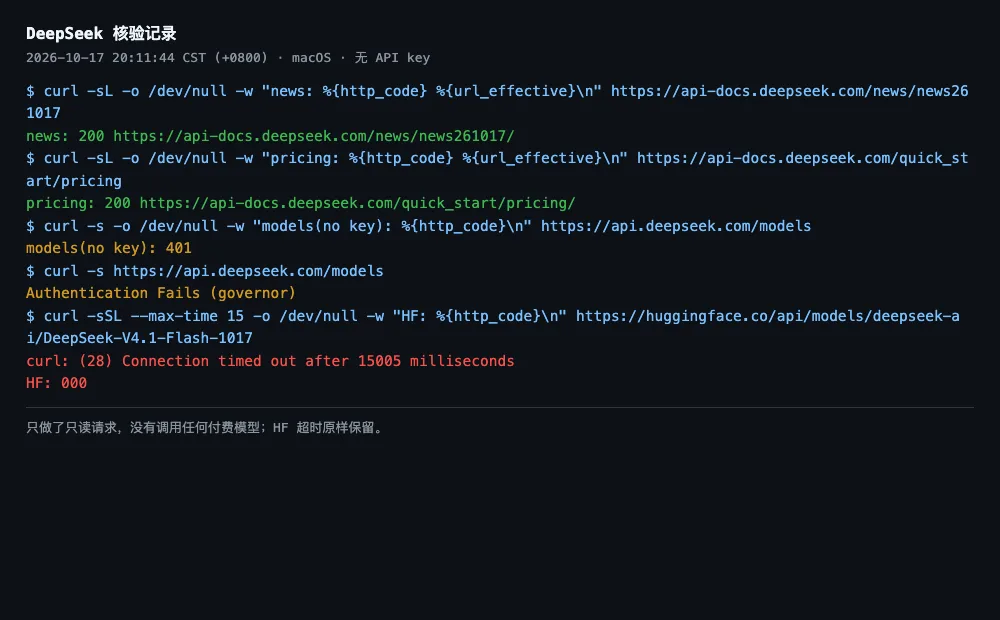
我本来想把 deepseek-v4-flash 和 deepseek-flash 各打一次,比较响应里的 model 字段;没有可用 key,这一步停住了。这不是省略,是没验到。
对四类人的影响,以及现在能做什么
| 人群 | 具体影响 | 现在能做什么 |
|---|---|---|
| 前端 / 全栈 | 调用名不变,背后模型换了;JSON 输出、tool call、vision 可能漂移 | 把现有的结构化输出用例重跑一遍 |
| AI 应用开发者 | model 名是滚动别名,不是权重版本;日志里只记名字无法区分快照 |
在网关层记录请求名、响应 model、日期 |
| 独立开发者 | 1M 上下文、MIT 权重、非高峰半价 | 批量任务挪到晚上或周末;关注 Search/Fetch 计费 |
| 团队 | 别名升级不需要改代码,但回归和预算需要人管 | 做别名映射、固定 prompt 回归、预算告警 |
四类人里,最该紧张的是把 model 名写进日志就以为完成了版本管理的人。名字相同,不代表输出相同。
具体动作我建议按这个顺序:
- 全局搜
deepseek-v4-flash和deepseek-v4-flash-vision-exp。还能用,但注释里要写清楚它已经退役,别再当旧模型依赖。 - 在调用层加一个字段,记录请求的 model 名、响应里的 model 字段、请求日期。如果响应里没有版本号,至少把日期和请求 ID 存下来。
- 准备 10–20 条固定 prompt,覆盖 JSON 输出、tool call、图片输入。升级后先跑一遍,别等用户告诉你。
- 批量任务改调度:北京时间 09:00–12:00、14:00–18:00 是高峰,挪到晚上或周末,价格减半。
- 如果 Search/Fetch 已经进流程,把 2026-10-31 16:00 UTC 写进预算表;免费期结束前重新算一遍每次任务的检索次数。
- 如果可复现性是硬要求,自托管 MIT 权重是一条路;但 484.6B 参数不是单机玩具,先算硬件账。不能自托管,就把关键输出缓存下来,至少能做对比。
我的判断,和另外三条值得看的更新
这次更新对绝大多数人是好消息:不用改代码,模型升级了,1M 上下文和 vision 还在,非高峰价格没涨。对需要可复现的团队,它是一个提醒:你 pin 的是名字,不是权重。
我的建议很具体:把 model 名当 API 版本,把权重版本单独记。能在网关层做映射,就不要散落在业务代码里;能自托管,就用 MIT 权重做一条离线回归;不能自托管,至少把响应里的 model 字段、请求日期和一批固定 prompt 的输出存下来。
什么证据会让我改口:如果 DeepSeek 公布可指定的日期快照(比如 deepseek-flash-20261017)并给出旧快照的下线时间表,或者我拿到 key 实测发现旧别名仍返回旧权重,我就把“别名不是版本”这句话收回一半。
接下来盯两件事:2026-10-31 16:00 UTC 的 Search/Fetch 计费生效;以及独立评测里 1017 在你这类任务上的表现。厂商说的 Pareto improvement,我这边没有复现。
FLUX 3 Image Klein:5.6B 也能在 8GB 显存上改图
10 月 15 日,Black Forest Labs 发布 FLUX 3 Image Klein:5.6B 参数、开放权重,BF16 占 11.2GB、FP8 占 5.6GB,INT8 版本能在 8GB 显存的 RTX 上跑;BFL API 的蒸馏版是 $0.009 per 1K images。注意它用的是 FLUX Kommunity License,不是 Apache/MIT,商用前先读条款。所以呢:本地改图的门槛又降了一档,但“开放权重”不等于“随便用”。(BFL 原文,2026-10-15)
OpenAI Python SDK 3.32 / 3.33:区域驻留与图片安全标识
OpenAI 的 Python SDK 在 10 月 16 日到 17 日连发 3.32.0 和 3.33.0:前者加 cache settings、prompt-based voice creation、区域驻留选项(枚举新增 JP/IN/AU 的 STORAGE_PROCESSING),后者给图片请求和响应加 safety identifiers。所以呢:用 SDK 管项目缓存和区域驻留的团队会先看到字段;平台侧是否对所有组织开放,我没核到,changelog 是 403。(3.32.0 / 3.33.0)
Anthropic Python SDK 1.15.0:Messages 多了 speed 参数
Anthropic 的 Python SDK 1.15.0 在 10 月 15 日发布:Messages 新增 speed(standard / fast)和 usage.speed,thinking types 新增 between_tools;文档备注部分模型要 beta header 才能用 speed。所以呢:多工具 thinking agent 可以显式选快档,但别默认所有模型都接。(v1.15.0)
模型名是给人看的,权重才是给机器跑的。名字不变的时候,更要把版本记下来。
FAQ · 常见问题
常见问题
deepseek-v4-flash 这个旧名还能用吗?
接口还认。价格页脚注逐字写着 deepseek-v4-flash 与 deepseek-v4-flash-vision-exp 这两个 legacy name 仍然被接收,但对应模型已经退役,请求由 DeepSeek-V4.1-Flash-1017 服务、按 Flash 单价计费。文档里没有一个可指定的日期快照名。
DeepSeek 的 Search 和 Fetch 怎么收费?
两个端点是 /v1/tools/search 与 /v1/tools/fetch,走同一套 Bearer 鉴权,每个 $0.75 per 1,000 calls、按成功请求计费。通过 DeepSeek Harness、Claude Code、Codex 的服务端工具调用目前免费,计费从 2026-10-31 16:00 UTC 开始;Search 的 count 默认 10、最多 50。
自托管这个 MIT 权重要先注意什么?
模型卡自己写着这一版不含 Jinja 格式的 chat template,别假设 tokenizer_config.json 里躺着一个现成的,官方补的是 encoding/encoding.py 和 deepseek-recipe。我只核到 ModelScope 的公开元数据:484.6B 参数、MIT、last_updated 2026-10-17,没下权重也没跑推理。
End of article · 读完这一篇
- 实际用时
- —
- 章节覆盖
- —
- 约读字数
- —
微信支付
支付宝