让 Agent 做一个落地页,它交回来的东西往往有同一套表情:标题上面一行小号大写字母,紫色渐变从左上铺到右下,三张图标卡排成一行,数字用 01/02/03 标好,最后一句 “Get started”。每一块都眼熟,合起来却不知道是谁的页面。
我拿这套模板做了一个故意很“AI”的对照页,又用 taste-skill 重做了一版。同一批博客封面,检查器在三个宽度下量出的 FAIL 从 11 个降到 0 个。但更有意思的不是这个数字,而是它怎么逼一个 Agent 先做决定,再去看自己的截图。
先说结论:它治的是“没做决定”,不是“不好看”
taste-skill 不是一套组件库,也不是一个更会写 CSS 的模型。它是一份给编码 Agent 的流程:先盘点这个对象独有的材料,再从研究过的方向里抽几个,选一个,写一句能把材料和版式连起来的概念,然后才动 HTML。
它也不承诺把页面变漂亮。README 里有一句很清醒的话:把装饰拿掉只是一半,另一半是内容、图片和真实信息;一个“没有套路”的空页面并不比一个堆满卡片的页面更好。
所以我把这次测试理解成一次“决策实验”,而不是“审美评分”。检查器只负责量出被禁用的套路,量不出一个页面是否值得读。0 个 FAIL 是起点,不是结论。
10 万 Star 的到底是什么:一套会验收的设计流程
截至 2026-10-24 抓取,Leonxlnx/taste-skill 在 GitHub 上是 101,508 Star、6,852 Fork,MIT 协议,2026-02-19 创建。README 里写的版本是 v2.1,定位是 Agent Skill,不是独立应用。
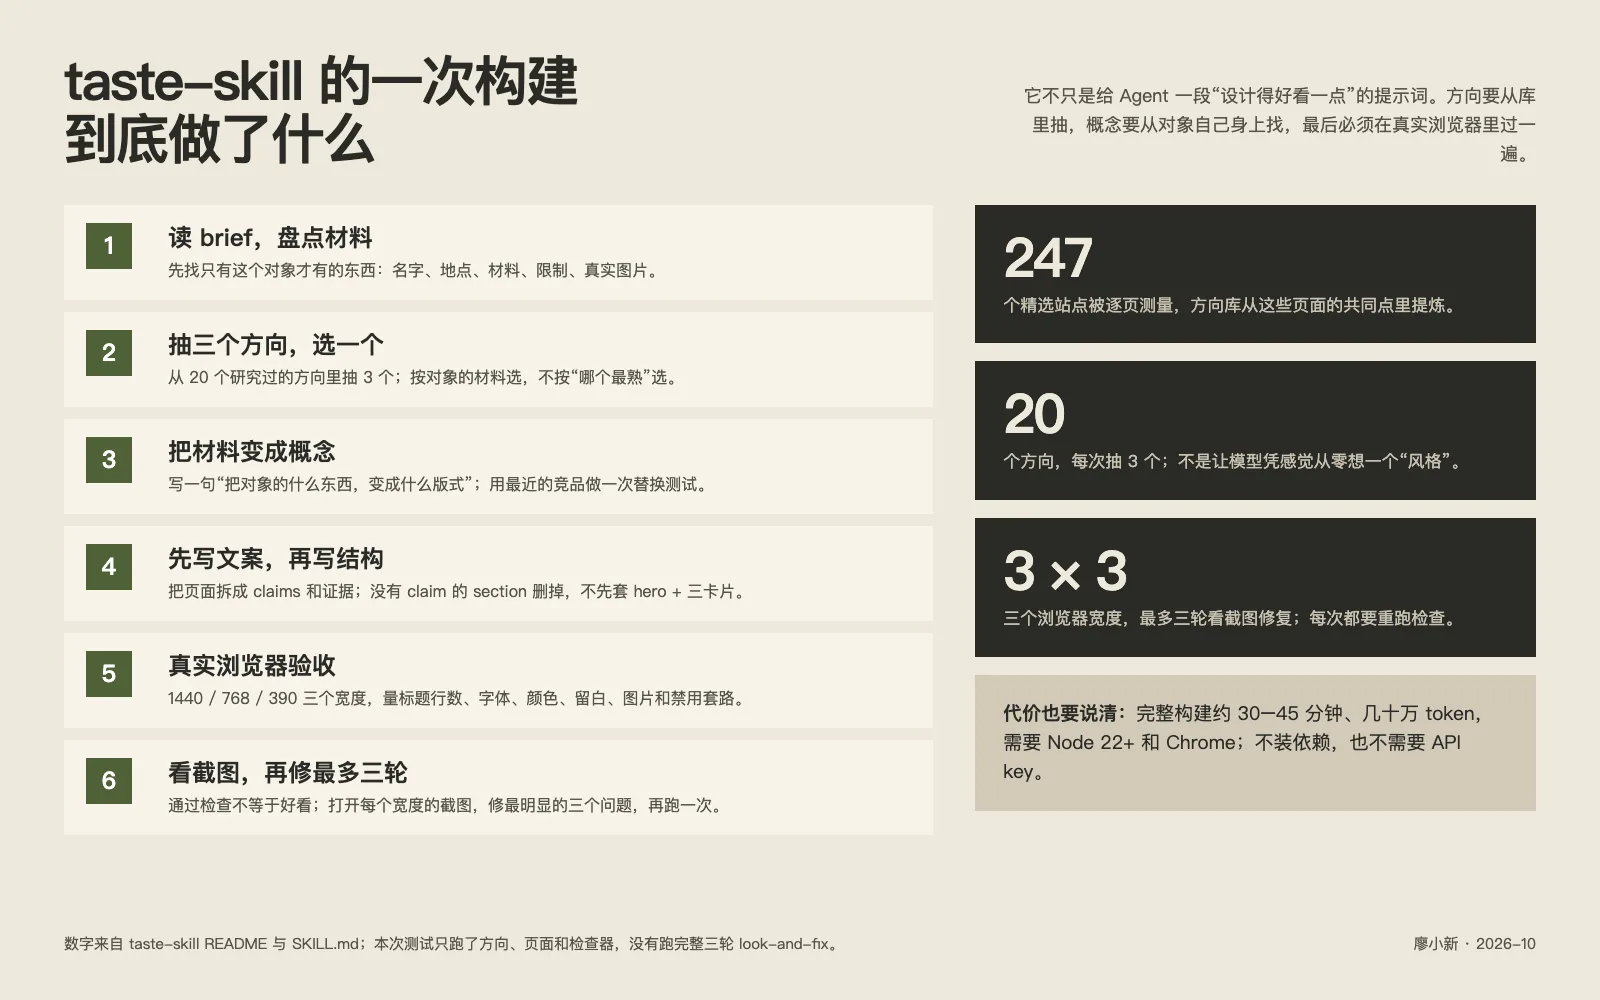
它的研究底稿来自 247 个精选站点:One Page Love 的最新页面,以及 Awwwards 的 Sites of the Day。作者把这些页面逐页测量,提炼出 20 个可以复用的方向。每次构建,脚本从 20 个里抽 3 个,Agent 按对象的材料选一个,而不是按“哪个最熟”选。
一次完整构建大概这样走:
- 读 brief,盘点只有这个对象才有的东西:名字、地点、材料、限制、真实图片。
- 抽三个方向,选一个;再抽这个方向的字体、配色、首屏和区块结构。
- 写一句概念,用最近的竞品做替换测试:如果换一个对象也成立,这个概念就还是品类的,不是这个对象的。
- 先写 claims 和文案,再决定 section;没有 claim 的 section 删掉。
- 在真实浏览器里按 1440、768、390 三个宽度验收:标题行数、字号、颜色、边距、空白、图片、溢出。
- 打开每个宽度的截图,修最明显的三个问题,再跑一次;最多三轮。
这六步里,真正和“提示词合集”拉开差距的是第 5、6 步。它不检查源码里有没有某个词,而是打开页面,量最终渲染出来的东西。源码看起来再干净,标题在 390px 下折成四行,检查器照样会报。
三个动作,把“审美”变成可执行的选择
第一个动作是抽方向,不是让模型凭空想一个风格。
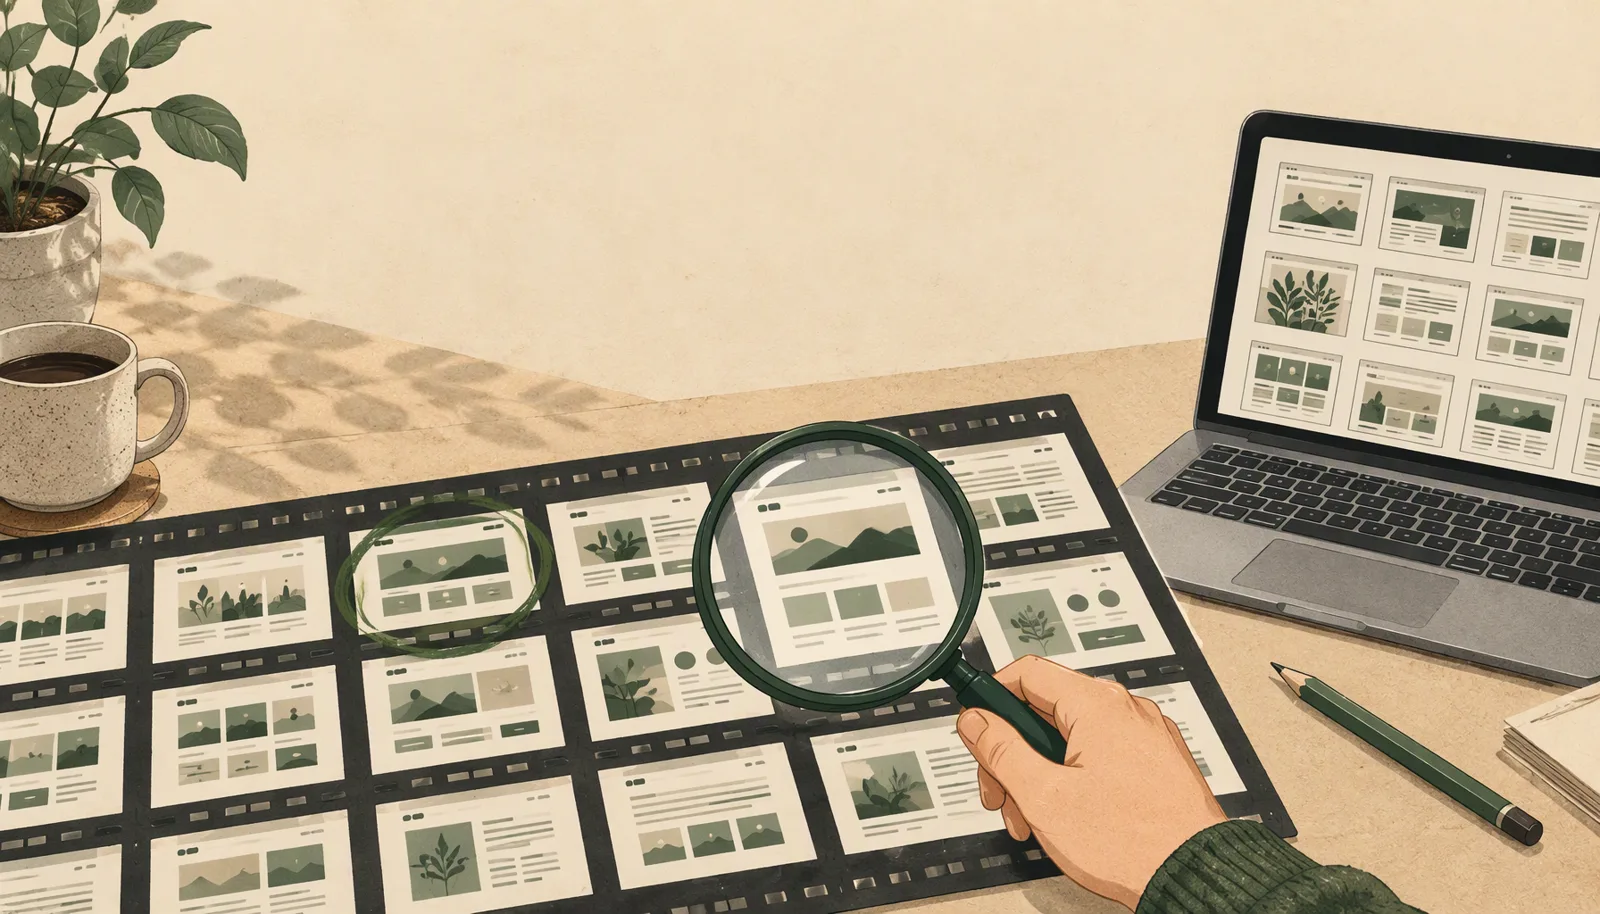
我在演示里跑 draw.mjs,拿到三个方向:pinned-poster、contact-sheet、quiet-instrument。最后选了 contact-sheet,理由是这次的对象不是单个产品,而是一组技术文章;把封面铺成摄影联系表,正好让“文章的数量和种类”成为页面本身,而不是再造一个 hero 去推某一篇。
方向表还给了字体、配色和区块顺序:Archivo,沙色底、炭黑字、苔绿一个强调色;intro、work、about、cta、footer 五个区块。种子是 788441068,重印方向表时能复现同一套选择。这个“可复现”很重要:设计讨论终于可以指向一个具体的 sheet,而不是“再大气一点”。
第二个动作是让规则有牙齿。
它禁用的东西很具体:标题上面的小号眉标、紫色渐变、静止元素的阴影、01/02/03 编号、一排图标卡、奶油色配陶土色、超过两行的标题、低于 16px 的正文、少于四张真实图片。检查器会逐条量。
这些规则不是全都来自数据。研究里的对比是:高分站点用图标卡的比例是 1%,低分站点是 28%;渐变是 22% 对 52%;静止阴影是 24% 对 48%;胶囊小标签是 14% 对 34%。但等宽字体、细线、01/02/03 在获奖站点里反而更常见,作者仍然禁用了它们,因为生成器正在模仿这些符号,它们已经变成了“戏服”。这条区分很重要:哪些是研究结论,哪些是作者的口味,README 和 SKILL.md 都写明了。
第三个动作是看截图,不是看代码。
inspect.mjs 会把页面在三个宽度下跑一遍,量标题行数、字体是否真的加载、颜色、边距、空白高度、图片数量、横向溢出,然后保存截图。Agent 要做的是打开截图,按它自己的评审表找最明显的三个问题,修完再跑。通过检查不等于好看,这一步是留给人的。
我拿同一页博客做了对照:11 个 FAIL 到 0
为了不让结论只停在 README,我做了一页演示:左边是故意使用常见 AI 模板的版本,右边是按 contact-sheet 方向重做的版本。两版素材都来自同一批已发布文章(封面、截图、图表),不是拿假截图互相比较。
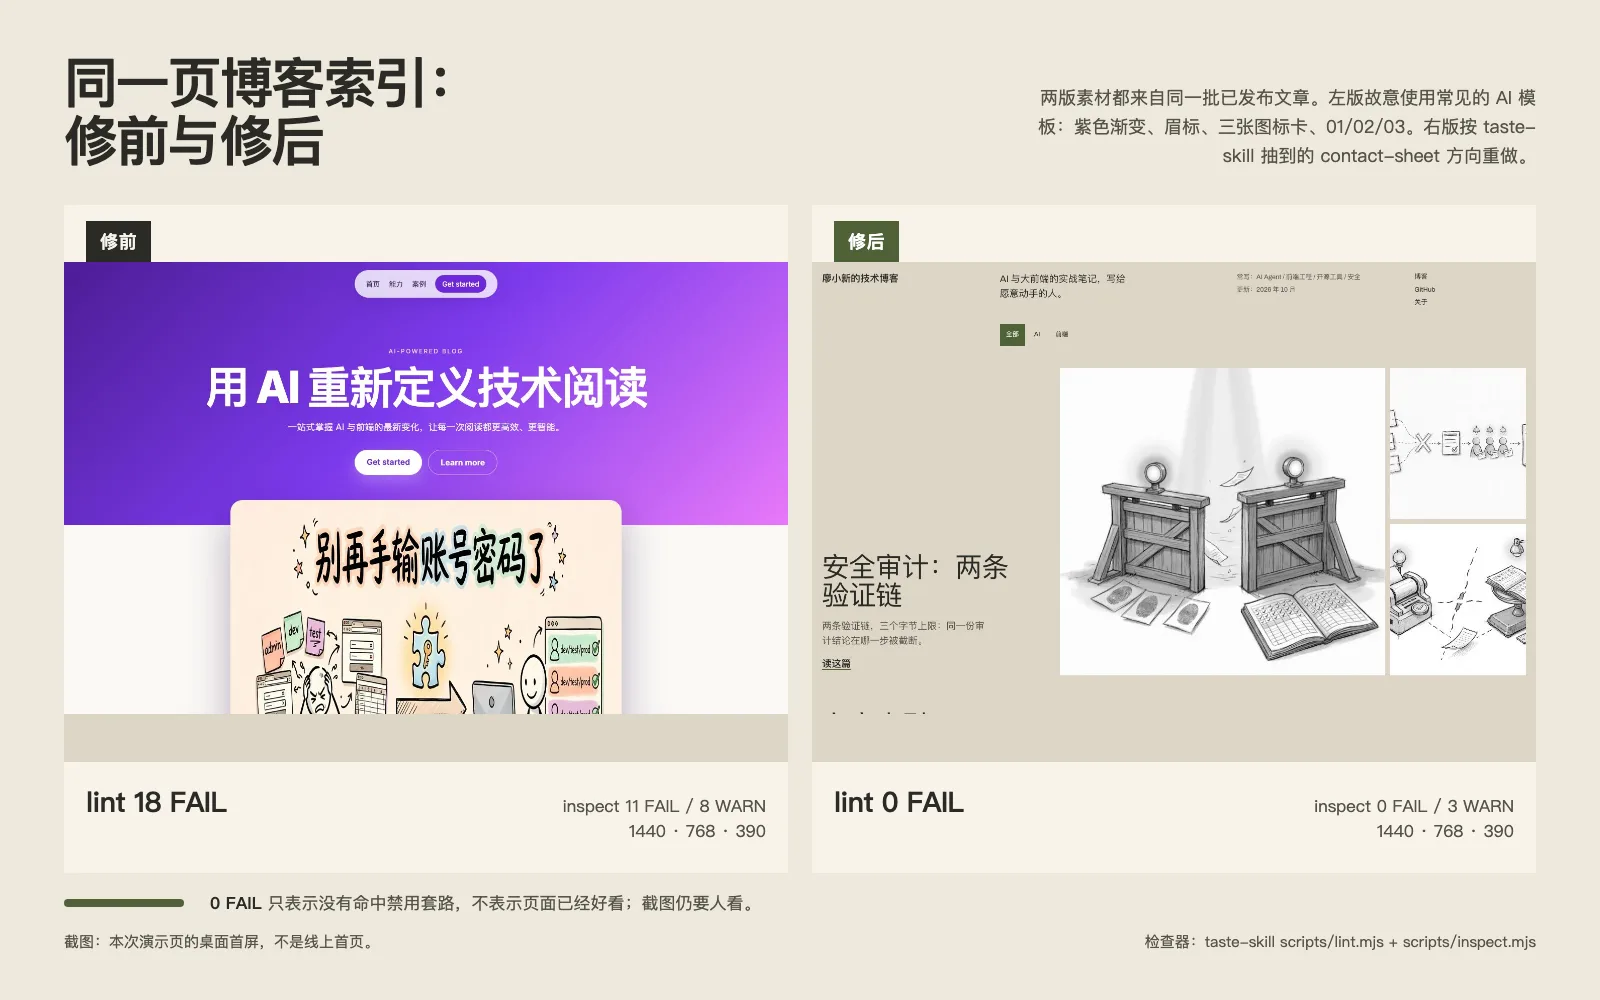
修前那版,我刻意放进了紫色渐变、眉标、三张图标卡、01/02/03、emoji、阴影和一条细分割线。lint.mjs 量出 18 个 FAIL、10 个 WARN;inspect.mjs 在 1440、768、390 三个宽度合计 11 个 FAIL、8 个 WARN。FAIL 的类型包括眉标、编号、emoji、渐变、阴影、按钮特效、细线、图标卡、紫色配色、页面没有动效,以及标题折行过多。
修后那版,我按方向表用了 21 张博客里的真实配图,统一成黑白联系表,悬停时恢复颜色;标题、正文和注释只用 Archivo 一套字;沙色底上只留一个苔绿强调色;加了一个按 AI / 前端筛选的交互,和一组滚动入场。lint.mjs 是 0 FAIL、0 WARN;inspect.mjs 是 0 FAIL、3 WARN。
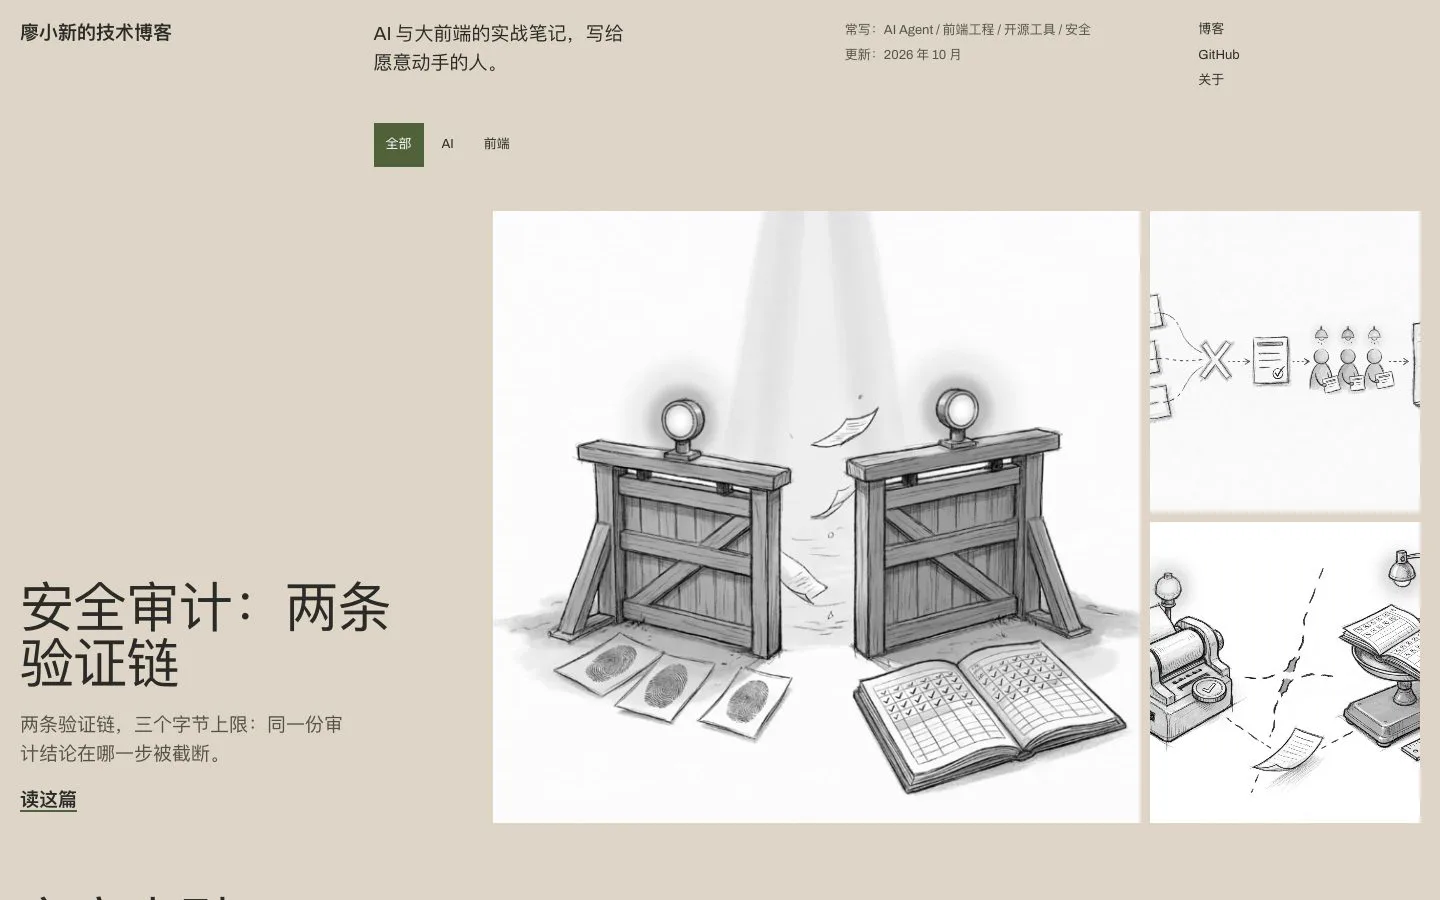
三个 WARN 我没有为了清零去改:
- 没有视频。 我没有一段诚实的、和文章内容相关的短片;随便找一段 stock 视频只会多一个装饰。
- h1 只有 19px。
contact-sheet方向明确要求名字按正文大小排,不设大标题;页面的重心交给联系表。检查器仍然按落地页的习惯提醒标题太小。 - 标题旁没有解释句。 检查器认为首屏只有名字、没有说明这是什么;实际上副标题就在右边一栏,只是方向表把名字和说明分在了不同列。一种改法是把说明挪到标题正下方,但那会改掉这个版式。
这三个 WARN 是这次测试最有价值的部分:规则和方向表会打架。taste-skill 自己给了一个优先级:先满足 house rules,再服从方向,再服从字体和配色,最后才是具体 blueprint。但有些冲突没法两边都满足,你得选一个,并把理由写进报告。选完还要承认:0 FAIL 只说明没有命中禁用套路,截图仍然要人看。
还要说清一个边界:这次我没有让 Agent 从头到尾跑完整的 30–45 分钟构建,也没有跑满三轮 look-and-fix。我跑通了 draw → build → lint → inspect 这条主链,用真实的 21 张图片做了一页可检查的页面。完整流程里的“看截图再修”是下一步,不是这次已经证明的事。
它真正有用的地方,不在禁用清单
如果只看禁用清单,taste-skill 很容易被学成一串 CSS 规则:不要渐变、不要阴影、不要 01/02/03。但修前那版的问题不是“用了一个紫色”,而是每个选择都可以替换成另一个 AI 工具的页面。它没有回答“这个对象为什么长这样”。
contact-sheet 给我的不是一个更漂亮的模板,而是一个决定:把文章封面、截图和图表当成同一张联系表上的证据,让读者先扫证据,再决定读哪篇。这个决定又带出了后面的选择:需要 21 张真实图片,需要统一的黑白处理,需要一个筛选器,需要把标题压小、把版面让给图。功能不是堆上去的,是被这个概念逼出来的。
如果你在选工具,可以先看这张表:
| taste-skill | 一次性设计提示词 | UI 组件库 | |
|---|---|---|---|
| 主要作用 | 逼 Agent 先定方向,再在浏览器里验收 | 给模型一段风格描述 | 提供现成的组件和样式 |
| 产出 | 方向表、页面、检查结果 | 一次性的页面代码 | 组件与设计系统 |
| 能否拦住模板套路 | 有明确规则和量测 | 依赖模型自觉 | 不负责页面结构 |
| 代价 | 30–45 分钟、几十万 token、要 Chrome | 快,但结果不稳定 | 要自己搭页面,容易长得像别人 |
| 适合 | 落地页、作品集、产品介绍页 | 临时页、快速草稿 | 已有设计系统的团队 |
这张表不是评分,是选型:你缺的是“做决定”和“验收”,还是只是缺一套组件?前者才值得上 taste-skill;后者用组件库更快。
浏览器验收也是同一个逻辑。修前那版在源码里看起来“完整”,但渲染出来标题折行、页面没有动效、图标卡排成三张一样的;这些都不是读 HTML 能一眼看出来的。把页面真的打开,量一遍,再打开截图看一遍,这个顺序比禁用清单更难被糊弄。
但它仍然只是一个检查器。它不知道你的品牌、你的用户、你的内容是否真实;它也不知道一个通过检查的页面是不是无聊。SKILL.md 自己说得很直白:通过 gate 只代表没有量到被禁用的东西,不代表页面好。这句话应该和工具一起被记住。
这些页面,别用它
只想十分钟做一个页面的人。 完整构建是 30–45 分钟、几十万 token 的量级;这次只跑主链也花了不少时间。为了一个临时页面上这套流程,成本不划算。
数据密集的仪表盘和后台。 v2.1 给 app screen 留了单独路径,规则和落地页不一样;但本文量的 landing page 规则(无细线、无 01/02/03、无等宽字)不应该直接套到表格和监控界面上。后台要的是扫读效率,不是联系表。
有严格品牌系统的团队。 它可以 --keep palette,type 保留品牌色和字体,但 house rules 仍然会禁掉一些品牌资产里常见的东西。上线前要决定:是改品牌,还是给规则开例外,并写清为什么。
只有几张图,却想做 contact-sheet 的人。 方向表自己写了:少于大约 20 张图,这个方向会显得没做完。我这次用了 21 张;如果只有四张,应该换方向,而不是硬把四张图放大成一张“作品集”。
没有时间看截图的人。 检查器能拦住套路,但拦不住一个空洞的页面。最后那一步“看截图、修三个问题”需要人;如果没人看,0 FAIL 只是一个更干净的模板。
想试的话,从一条命令开始
官方给的安装命令是一条:
npx skills add https://github.com/Leonxlnx/taste-skill --skill "design-taste-frontend"
为了不污染本机的 skill 目录,我这次直接把仓库 clone 到临时目录跑脚本。装好之后,最小的工作流是:
# 看三个方向,选一个
node <skill>/scripts/draw.mjs --sector personal-portfolio \
  --brief "你的对象,一句话说清它做什么" \
  --sections intro,work,about,cta,footer --options 3

# 展开选中的方向,拿到字体、配色和区块
node <skill>/scripts/draw.mjs --sector personal-portfolio \
  --brief "你的对象,一句话说清它做什么" \
  --sections intro,work,about,cta,footer --direction contact-sheet

# 静态扫描 + 真实浏览器验收
node <skill>/scripts/lint.mjs index.html style.css app.js
node <skill>/scripts/inspect.mjs index.html
inspect 需要 Node 22 以上和 Chrome、Edge 或 Chromium;draw 和 lint 对版本的要求更低。整个过程不需要 API Key,但找开放图片要联网,图片的许可和署名要自己核对。
第一次用,建议只拿一个页面做对照,不要直接上整站。先准备一个真实的 brief 和一批真实素材;如果素材不够,就换一个方向,或者先别用这个技能。
最后的判断
taste-skill 值得试,但值得试的不是“它能让页面变好看”,而是“它把设计从一句形容词变成了一串必须回答的问题”:这个对象只有什么、选哪个方向、概念一句话能不能成立、每个 section 有没有 claim、在 390px 下标题会不会折、截图里最难看的三处是什么。
如果你正在用 Agent 做落地页、作品集或产品介绍页,而且已经受够了那种“每块都眼熟、合起来不知道是谁”的页面,它值得花一个晚上跑一遍。如果你要的是十分钟出稿、数据密集的后台,或者一个严格品牌系统,先用别的办法。
我自己的判断是:它最适合“有一个真实对象、有一批真实素材、愿意花时间看截图”的场景;不适合把它当成万能 UI 生成器。如果未来它能把完整构建压到更短、把标题和说明句的位置判断做得更准,我会更愿意把它放进日常流程;如果它仍然要求 30–45 分钟和几十万 token,那它更像一次认真的设计冲刺,而不是每天的默认工具。
先做一页对照,再决定要不要把它放进你的工作流。0 FAIL 不是奖杯,只是一个更干净的起点。
FAQ · 常见问题
常见问题
taste-skill 能替代设计师吗?
不能。它把先做决定、再做页面、最后看截图变成流程,能拦掉一批模板套路;审美判断、品牌约束和真实内容仍然要人负责。
它适合仪表盘和后台吗?
v2.1 给 app screen 留了单独路径,规则和落地页不同。本文测的是落地页;数据密集的界面不能直接套落地页的无细线、无 01/02/03 规则。
需要 API Key 或安装依赖吗?
不需要 API Key,脚本本身零依赖,但 inspect 需要 Node 22 以上和 Chrome、Edge 或 Chromium。找开放图片要联网,图片的许可和署名要自己核对。
End of article · 读完这一篇
- 实际用时
- —
- 章节覆盖
- —
- 约读字数
- —
微信支付
支付宝