10 月 15 日 23:46(UTC+8),Hugging Face 上 meta-models/Muse-Spark-Open-816B-A42B 这个仓库的更新时间停在了这一刻。65 个 safetensors 分片,我把字节数加了一遍:1,644,333,393,864 字节,1.64TB。参数规模 816B,激活 42B,上下文 1,048,576。
我第一件事不是下载,是去看许可证。原因很实际:这套权重按 BF16 算,光参数就要 1.6TB 以上内存,我这台 Mac 连一个分片都装不下。
许可证的第二条比 816B 更能决定它能不能进你的产品:用了模型或衍生品的每个产品,都要在 UI、文档、网站或设置菜单里醒目地写一行 Built with Muse Spark Open。
10 月 15 日深夜,权重和许可证一起上线
Meta 的官方发布页在 research.meta.ai/blog/muse-spark-open。我在本机用 curl 打开它,返回 000;换 WebFetch 也失败。所以这篇不引用 Meta 自己的 benchmark 表,只写我能从模型仓库、框架文档和第三方实测里核到的东西。
能核到的时间线如下。
| 时间(UTC+8) | 发生了什么 | 我核到的依据 |
|---|---|---|
| 2026-10-15 23:46 | HF 仓库更新(lastModified),权重与许可证上线 | HF 模型页,API lastModified 为 2026-10-15T15:46:43Z |
| 2026-10-15 | 许可证正文写明 Release date: October 15, 2026 | HF 元数据里的 cardData.extra_gated_prompt |
| 2026-10-16 00:58 | HN 上的一条早期提交(72 points) | HN 50106620,Algolia API 读数 |
| 2026-10-16 01:35 | Transformers PR #49644 合并,标题 “Add Muse Spark Open” | PR #49644,merged_at 2026-10-15T17:35:26Z |
| 2026-10-15 | Apple ML Research 发布四台 Mac Studio 的 MLX 实测 | Apple ML Research |
| 2026-10-15 | Together 上架 serverless API | Together 模型页,标注 Released October 15, 2026 |
| 2026-10-17 22:05 | 我读取 HF 元数据:815 downloads、456 likes、gated=manual | HF API(经镜像站),快照时间见证据底稿 |
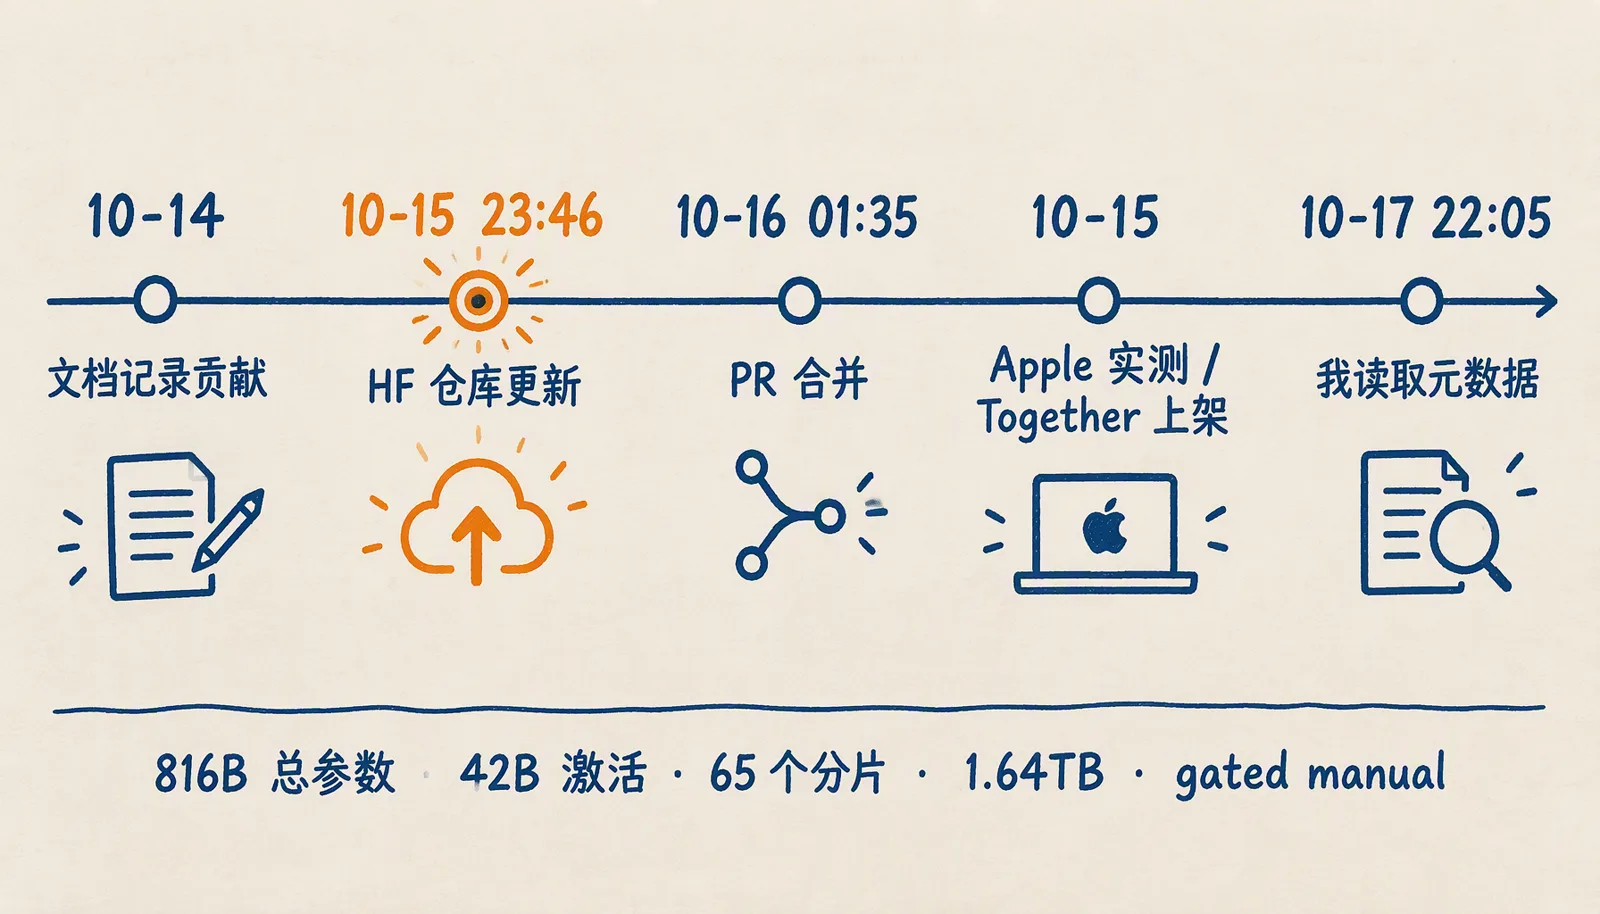
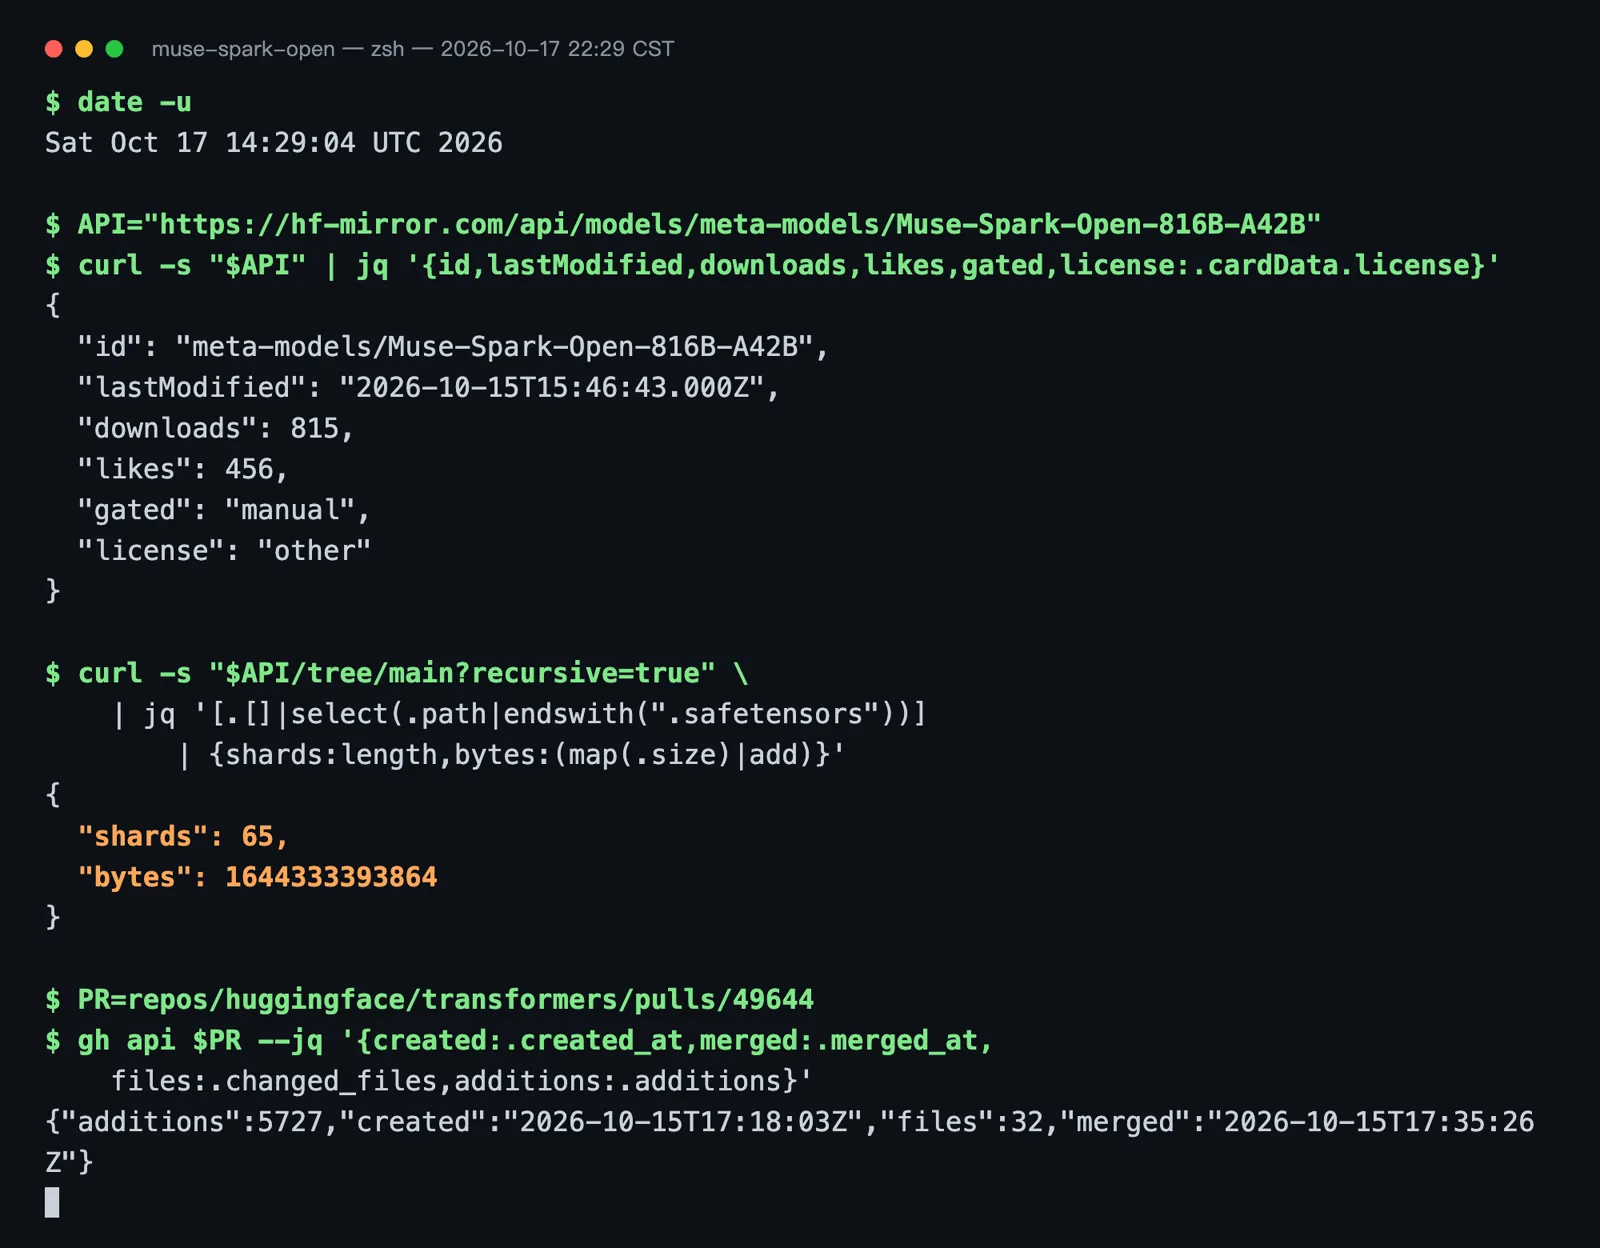
这张表里最值得注意的不是 816B,而是权重上线后不到两小时,Transformers 的 PR #49644 就合并了。至少从结果看,Meta 这次不是只丢一个 checkpoint 出来让社区自己适配。PR 的创建时间是 17:18 UTC,合并是 17:35 UTC,17 分钟,32 个文件,5727 行新增。
当然,这是社区贡献者 guarin 提的 PR,不是 Meta 自己维护的框架分支。它能说明“生态跟得很快”,不能说明“官方支持已经成熟”。
65 个分片、1531.4GiB:先算内存账
我把 HF API 的文件列表拉下来,用 jq 把 65 个 safetensors 的 size 相加:1,644,333,393,864 字节。换成 GiB 是 1531.4,换成十进制是 1.64TB。
用 1.64TB 除以 816B,得到约 2.01 字节/参数。这个读数符合 BF16(2 字节/参数),也解释了为什么 Apple 在博客里说 BF16 参数本身就要 1.6TB 以上内存。
我一开始以为 65 个分片里会混着 NVFP4,拉完文件列表才发现主仓库里没有名字带 nvfp4 或 fp4 的独立分片。Transformers 文档说 checkpoints 有 BF16 和 NVFP4 两种格式,但 NVFP4 放在哪个仓库、哪条分支,我这轮没验到。
| 形态 | 权重大小 | 还需要什么 | 能不能单机 |
|---|---|---|---|
| BF16 | 1.64TB(我按 HF 文件列表算的) | KV cache、激活、框架开销 | 不能;Apple 说 BF16 参数本身就要 1.6TB 以上 |
| NVFP4 | 约 493GB(Apple 读数) | 中间计算内存;Apple 说加完仍不能单机 | 不能,至少多机 |
| Together API | 0 | 网络与 token 费用 | 能,按量付费 |
所以“开放权重”的第一道门不是许可证,是内存。对个人开发者,这道门基本是关着的。
许可证不是 Apache 2.0:一行署名的代价
HF 元数据里的 license 字段是 other,license name 是 muse-model-license。许可证正文给了很宽的权利:使用、复制、修改、微调、蒸馏、合并、发布、分发、再许可、销售都写了。
许可证正文列了几条义务,其中两条最影响产品。
第二条是署名:每个用了软件或衍生品的产品或服务,要在 UI、随附文档、网站或设置菜单里醒目显示 Built with Muse Spark Open。衍生品也包括用它的输出训练或蒸馏出来的模型。
第三条是 MaaS 门槛:如果你把模型或衍生品作为 Model as a Service 提供给第三方,且你和关联公司任意连续 12 个月的合计总营收超过 2000 万美元,就要先通知 Meta 并签单独协议。内部使用、研究、非 MaaS 的商业活动不受这条约束。
还有一层摩擦:模型是 gated manual。下载前要填真实姓名、出生日期、国家、机构、职位,表单还会读 IP 地理位置。我在镜像站请求 README 时收到 403 This model is not available in your region.;直连 HF 在这台机器上超时。我无法判断这是 Meta 的区域限制还是镜像站策略,所以不把“中国不能用”写成事实。
还有一条对你有利:Meta 明确不主张模型输出的所有权。但输出仍受 Usage Policy 约束,商用前最好把用途条款也过一遍。署名这件事,我的建议是别只写在一个地方:产品 UI、设置菜单和随附文档各放一处,成本很低,漏掉的风险小很多。
这三条里,最容易漏的是署名。它不是“致谢”,是许可证条件;漏了就不符合许可证要求。
这也是我不把它叫“开源”的原因。Apache 2.0 和 MIT 没有这种按营收规模单独签约的条款;它有署名和 MaaS 门槛,更准确的叫法是“开放权重 + 商用许可 + 附加条件”。
苹果用四台 Mac Studio 跑出 36.73 tokens/s
Apple ML Research 在 10 月 15 日发了一篇实测:4 台 Mac Studio,M5 Ultra,统一内存最高 512GB,MLX v0.30.1+,RDMA over Thunderbolt 5。Muse Spark Open 用 NVFP4,4 机 tensor parallel,8192 context 下 decode 36.73 tokens/s,TTFT 4.8 秒。
单机跑不了。Apple 写得很直接:BF16 参数本身要 1.6TB 以上内存;NVFP4 把模型内存降到约 493GB,加上中间计算,仍然不能塞进一台机器。
2 机 pipeline 是 15.74 tokens/s,2 机 tensor 是 24.99 tokens/s,4 机 tensor 是 36.73 tokens/s。4 机比 2 机 tensor 只快了约 47%,不是线性翻倍。机器多了一倍,decode 只多了不到一半,多机互联和 tensor parallel 的开销吃掉了接近一半的增量。这也是我不建议按机器数量线性估吞吐的原因。
按 36.73 tokens/s 粗算,生成 1000 个 token 要约 27 秒。这不是聊天框的体验,更像批处理。
Apple 自己也提到,大 context 下 tensor parallel 有开销,实现比 pipeline parallel 复杂。这组数字证明的是“能跑”,不是“能上线”。
Together 的 $1.25/$4.25:今天更现实的接入方式
Together AI 已经把模型上到 serverless:input $1.25 / 1M,cached input $0.15 / 1M,output $4.25 / 1M,context 1M,输入支持文本、图像、音频、视频,输出文本。页面标注 Released October 15, 2026。
我算了一笔账:同样生成 100 万 output token,Together 收 $4.25;你要自托管,先准备 1.64TB 的 BF16 权重或约 493GB 的 NVFP4 权重,再加多机互联和运维。对独立开发者,API 是唯一合理的第一步。
但 API 也不是没有代价。1M context 意味着长文档、长代码库场景的 token 账单会很难看;output $4.25/1M 对高频生成场景也不便宜。先用 8k–32k 的真实任务测,不要一上来就灌 1M。
再算两笔具体的账:一次把 1M context 灌满的请求,input 就是 100 万 token,按 $1.25/1M 算约 $1.25;一天 1000 次就是 $1250。生成 10 万 output token 约 $0.425;一天 1000 万 output token 约 $42.5,一个月约 $1275。先把这两个数写进预算,再谈要不要上。
| 路径 | 门槛 | 成本 | 适合谁 |
|---|---|---|---|
| Together serverless | 注册、付款 | $1.25 / $0.15 cached / $4.25 per 1M | 快速验证、产品原型 |
| 自托管 BF16 | 1.64TB 权重 + 多机 | 硬件、机房、运维 | 有集群的团队 |
| 自托管 NVFP4 | 约 493GB 权重 + 中间计算 + 多机 | 硬件、机房、运维 | 追求吞吐的团队 |
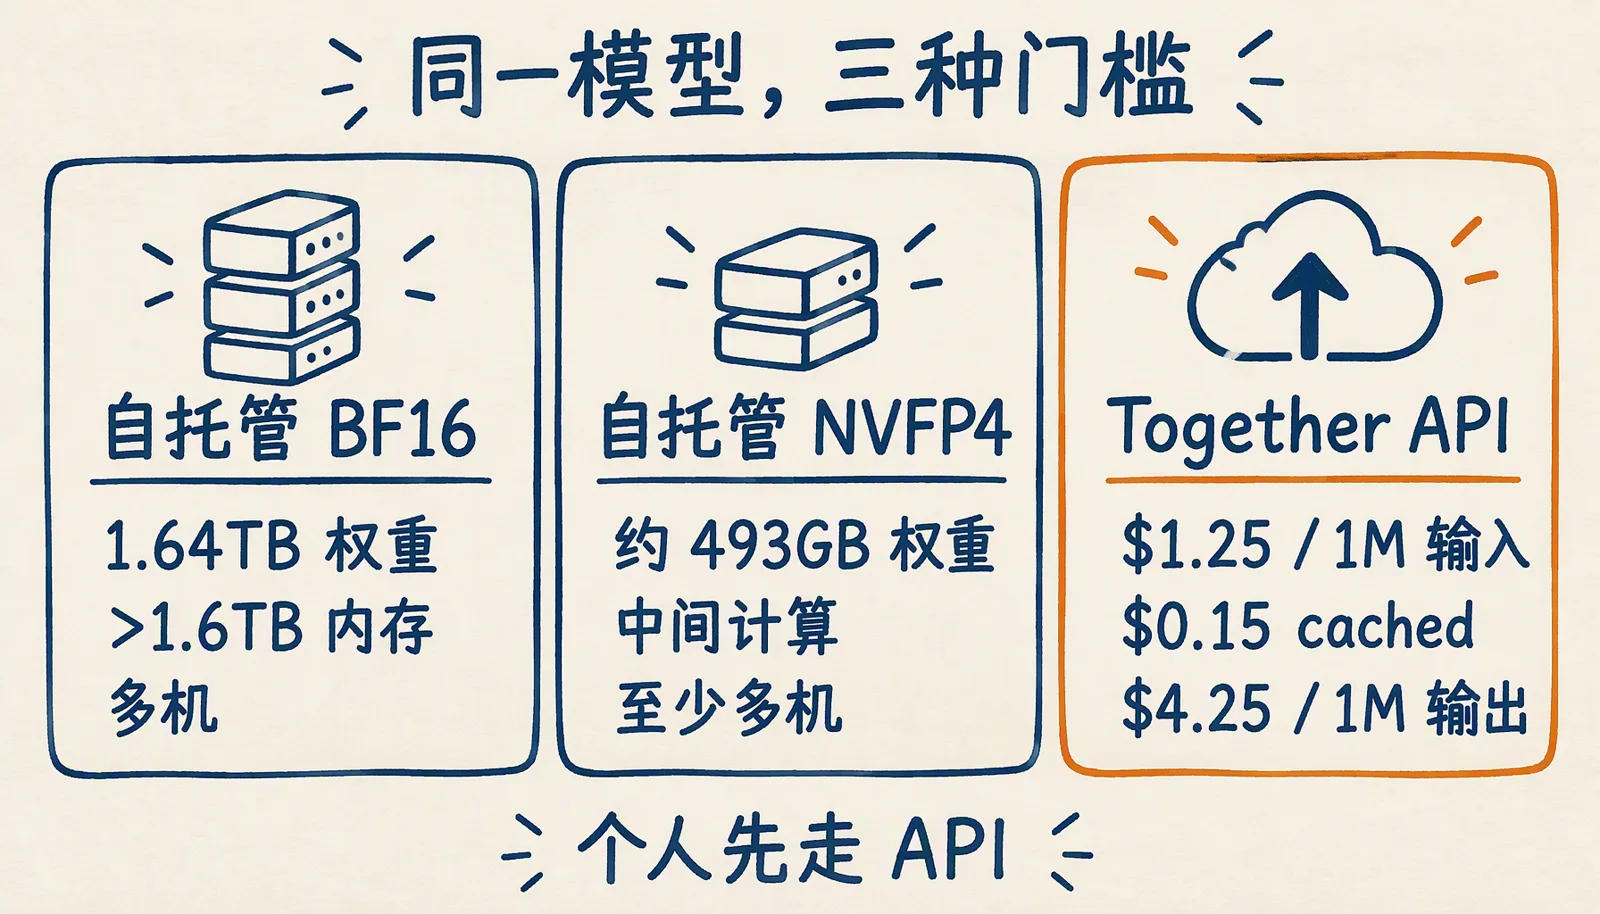
我的判断:这条模型的第一价值不是“免费下载”,是给闭源 API 增加了一个可审计的备胎。你未必要跑它,但你可以拿它的价格和许可证去谈别的供应商。
前端能接 API,独立开发者先别下权重
| 人群 | 今天能做什么 | 主要卡点 |
|---|---|---|
| 前端 / AI 应用开发者 | 用 Together 接多模态输入 + 1M context,做代码库问答、长文档理解 | token 成本;输出只有文本 |
| 独立开发者 | 先用 API 验证需求,不要为“开源”买多机 | 1.64TB BF16 或约 493GB NVFP4;gated 申请 |
| 团队 / 企业 | 评估微调、蒸馏;把署名写进产品合规清单 | 2000 万美元 MaaS 条款;许可证不是 Apache |
| 推理基础设施 | 试 NVFP4 + 多机并行,关注 1M context 吞吐 | NVFP4 checkpoint 位置未确认;并行开销 |
前端开发者是这波里最舒服的:不用碰权重,接 API 就能用。最不舒服的是想“把模型搬回自己机器”的独立开发者,因为这次的单位是 TB,不是 GB。
今天就能做的三件事,和两个要盯的信号
- 想验证能力:拿一个 8k context 的真实任务,比如把一个中型仓库的 20 个文件喂进去做重构建议,用 Together 跑一次,记录 input/output token 和延迟,再决定要不要上 1M。
- 想自托管:先确认 NVFP4 checkpoint 的实际仓库和推理配方;按约 493GB 权重 + 中间计算 + KV 预留做容量计划,不要按单台 512GB Mac Studio 下单。
- 想商用:把
Built with Muse Spark Open写进 UI、文档、设置菜单的发布清单;如果做 MaaS 且营收可能超过 2000 万美元,提前找法务和 Meta。
两个要盯的信号:Meta 是否放出独立的 NVFP4 仓库和单机推理配方;Together 是否调整 output 价格,或者出现第二家同价 provider。
什么证据会让我改口:如果两周内出现能在单台 512GB 机器上稳定跑 8k context 的 NVFP4 配方,或者 Together 把 output 降到 $2/1M 以下,我这条“个人别自托管、API 先用着”的判断就作废。
短讯:Anthropic 的 fast 模式、微软 2.8T 与 OpenAI 的图片字段
DeepSeek V4.1 Flash 的别名与价格变化,今天早些时候单独写过一篇,这里补三条不在那篇里的更新。
Anthropic 把 fast 模式写进了 SDK 类型。 2026-10-15 发布的 Python SDK v1.15.0 在 Messages 里新增 speed: "standard" | "fast",返回的 usage 也多了 speed 字段。SDK 注释写明,部分模型用任何 speed 值都需要 fast-mode-2026-02-01 beta header;文档把 fast 模式描述为 Opus 5.5 的 2.5 倍速配置,价格 $8/$40 per 1M tokens,文档仍把它标为 research preview。所以呢:做低延迟交互的团队可以试,但别把它当稳定档位,先确认你的模型和账户是否在灰度范围内。
微软的 2.8T 模型完成预训练,但还不是产品。 2026-10-15,Microsoft AI 公布 MAI-Base-2:MoE,80B 激活 / 2.8T 总参数,16k GB200 训练 38 天,平均 MFU 21%、goodput 89%。官方明确说它还在 post-training,权重将通过 Foundry 授权给可信伙伴,不是开放下载。所以呢:这是一条“下一个前沿基座”的信号,不是今天能接的 API;它和 Meta 的开放权重放在一起看,2026 年下半年两条路线的分化更清楚了。
OpenAI 给图片接口加了 safety_identifier。 2026-10-17 00:28–00:29 UTC,Python SDK v3.33.0 和 Node v7.36.0 发布,图片创建和编辑请求可以传 safety_identifier,响应会回显实际生效的值;旧的 user 参数保留但标记为 deprecated(PR #2957 于 2026-10-16 21:41 UTC 合并)。所以呢:做图片生成或编辑的产品,应该给每个终端用户传一个稳定的哈希 ID,别传邮箱或手机号;同时用响应里的字段把日志和请求对上,否则排查滥用时对不上。
回到开头那行字。816B、1.64TB、36.73 tokens/s 都很抓眼,但真正会卡住产品上线的,可能是许可证里那句 Built with Muse Spark Open。权重放出来是一回事,能不能把它放进你的产品、你的账单和你的法务清单,是另一回事。
FAQ · 常见问题
常见问题
Muse Spark Open 的权重能不能自托管?
先算内存。我把 HF API 的 65 个 safetensors 字节加了一遍:1,644,333,393,864 字节,即 1531.4 GiB,除以 816B 得约 2.01 字节每参数,正合 BF16。Apple 写道:BF16 参数本身就要 1.6TB 以上内存,NVFP4 降到约 493GB 再加上中间计算仍塞不进一台机器。
它的许可证和 Apache 2.0 差在哪?
license 字段是 other、名字是 muse-model-license,而且是 gated=manual:下载前要填真实姓名、出生日期、国家、机构、职位,表单还读 IP 地理位置。使用、微调、蒸馏、再许可、销售都放开,但两条义务卡产品:每个用了它或衍生品的产品要醒目显示 Built with Muse Spark Open;做 MaaS 且任意连续 12 个月合计营收超 2000 万美元要先通知 Meta 并签单独协议。
Apple 那组多机吞吐能当上线依据吗?
它证明能跑,不是能上线。4 台 Mac Studio、M5 Ultra、MLX v0.30.1+,NVFP4 加 4 机 tensor parallel,8192 context 下 decode 36.73 tokens/s、TTFT 4.8 秒;2 机 tensor 是 24.99、2 机 pipeline 是 15.74,机器翻倍 decode 只多约 47%。按 36.73 粗算,生成 1000 个 token 要约 27 秒。
End of article · 读完这一篇
- 实际用时
- —
- 章节覆盖
- —
- 约读字数
- —
微信支付
支付宝