把密码从旧工具搬过来:表头识别、合并与加密备份
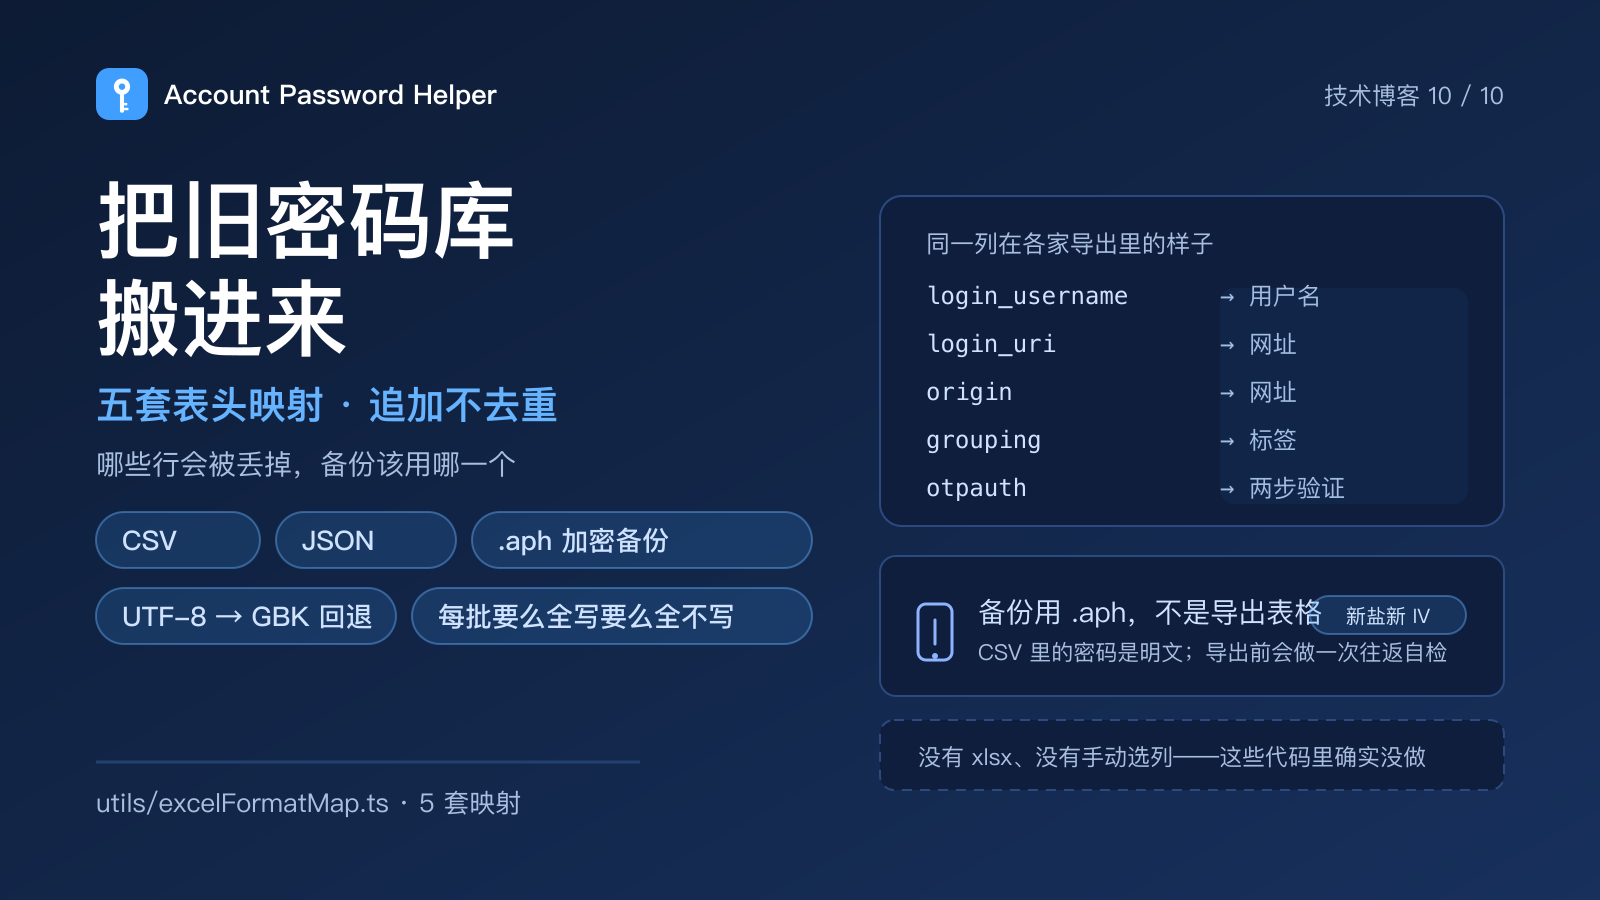
搬家是密码管理器最容易翻车的一步:新工具再好,你要是不敢把旧库导进来,它就永远是个空壳。而大部分「导入教程」都写成了「点一下就好了」,把人真正会撞上的东西全略过了——哪一列被认出来了、哪一行被静默丢了、重复的账号怎么办、导完要不要把旧库删掉。
这篇按代码实际做的事来讲。先给三条最反直觉的结论:
- 导入是追加,不去重。 这不是缺陷,是刻意的设计,理由在下面。
- 认表头这件事有五套映射,覆盖扩展自己的格式和四类主流工具的导出列名;认不出的列会变成空值,不会报错。
- 真正的备份不是导出表格,而是
.aph那个加密文件——表格里的密码是明文。
一、先搞清楚各家导出的是什么
主流工具几乎都能导出 CSV,但列名彼此不像话:同一个「网址」概念,一边写 URL,一边写 origin,一边写 login_uri。所以适配工作的实质不是「支持某个工具」,而是「支持一套表头」。
代码里目前是这样分的(utils/excelFormatMap.ts),六个内部字段:用户名、密码、网址、标签、备注、两步验证。
| 来源映射 | 用户名 | 密码 | 网址 | 标签 | 备注 | TOTP |
|---|---|---|---|---|---|---|
| 扩展自身 | 用户名(必填) / 用户名 / 账号 / username |
密码 / password |
网址 / URL / 网站地址 / 链接 |
标签 / 分类 |
备注 / 说明 |
两步验证 / 密钥 |
| 浏览器自带 | username |
password |
url / origin |
name |
note |
otpauth / otp_auth |
| LastPass | username |
password |
url |
grouping |
extra |
totp |
| Bitwarden | login_username |
login_password |
login_uri |
folder |
notes |
login_totp |
| 1Password | Username |
Password |
Url |
Title |
Notes |
OTPAuth / totp |
识别过程是这样走的:表头先按精确匹配,没命中再做大小写不敏感的回退;每个单元格进来都会 trim。自动判断来源那一档看的是「这行表头里有没有 origin」这类形状特征,默认落到浏览器自带那一套;如果第一轮一种格式都没认出内容,它会再遍历其余格式各试一次,而不是直接放弃。
还有一条中文用户特别需要的:文件先按 UTF-8 解码,若那一轮解析不出任何结果,再用 GBK 重试一次。要说准一点:触发回退的是「没解析出东西」,不是「解码报错」——UTF-8 那一路走的是非致命解码,本身不会抛异常。国内各种工具导出的 CSV 经常是 GBK,少了这一步,导进来的账号名会是一堆乱码方块。
二、哪些行会静默消失
这是最容易让人以为「导入丢数据」的地方,规则其实写得很清楚,只是没人读:
- 用户名那一格是空的 → 整条丢掉。 这是最常见的一类静默丢行:一个账号标识都没有的条目,进了库也只会变成没法检索的垃圾。
- 这一行解析出来的单元格少于两格 → 跳过。 判的是列数,不是「内容是否为空」,所以一行里只有一格东西(比如整行就一个 URL)会在这里被拦下。
- 认不出来的列变成空值,不影响这一行的其它字段,也不会报错。
- 只有一行表头、没有数据的文件,结果是空列表,界面会说「文件中没有找到有效的密码数据」,不会假装成功。
要坦白一件事:没有「手动选列」的界面。如果你的工具导出了一套很小众的表头,映射不上,正确做法是改表头而不是等这个扩展加功能——把第一行改成 用户名,密码,网址,标签,备注,两步验证 就能被自身那套映射接住,「下载模板」给你的就是这个形状。
三、为什么导入刻意不去重
[...现有列表, ...新导入],每条都是新生成的 id,追加写在末尾。看上去「不够聪明」,但这个选择有三个理由:
- 判重本身没有安全默认值。 按 URL 判会把
dev.example.com和example.com当成一家——而多环境账号恰恰是这个工具的主要场景,把两套环境的账号合并成一条,损失比重复严重得多。 - 去重是一个独立的、可撤销的动作:「一键去重」按「用户名 + 网址」分组,确认框会先把「归成了几组、涉及多少条」报给你,再决定是否处理。导入那一瞬间就自动改写数据,是不可撤销的。
- 导入失败的代价应该是「重复」,不该是「缺失」。重复了顶多再点一次去重;静默合并掉的字段是找不回来的。
所以合理的搬家顺序是:先导一次 → 抽查几条 → 需要时用一键去重收拾。别在导入之前先想着「会不会重复」。
四、三道闸门:文件、条目、库容量
导入路径上有三个独立上限,各挡一种情况:
| 闸门 | 阈值 | 挡住的是 |
|---|---|---|
| 文件字节数 | 32 MiB | 拿整库备份文件误投递到 CSV 导入框、或畸形大文件 |
| 解析出的条目数 | 10000 条 | 解析结果爆炸,撑爆内存与后续加密 |
| 库容量 | 2000 条 | 导入后整库写不进存储 |
字节闸门刻意排在读取文件内容之前,这样超限时连一次不必要的整文件 IO 都不发生。库容量那道更贴近真实使用:如果你已有 1950 条、这次要导 200 条,它会按剩余空间切片、二次确认,你取消就一条都不写。写入本身是整批语义——要么全写,要么全不写,不会出现「导了一半、库里多了 37 条来路不明的数据」。
五、搬家时什么会被带过来,什么不会
这张表是我希望自己在动手之前就看到的:
| 数据 | CSV | JSON | .aph 加密备份 |
|---|---|---|---|
| 用户名 / 密码 / 网址 | 会 | 会 | 会 |
| 标签 | 会 | 会 | 会 |
| 备注 | 会 | 会 | 会 |
| TOTP 密钥 | 会 | 会 | 会 |
| 收藏状态 | 不会(CSV 里没这一列) | 只有布尔值才保留 | 会 |
| 原始创建 / 更新时间 | 不会,一律写导入时刻 | 会 | 会 |
| 密码历史快照 | 不会 | 不会 | 不会 |
| 回收站里的条目 | 不会 | 不会 | 不会 |
两个容易踩的点:CSV 不带收藏,所以把 CSV 当备份的人搬家后会发现收藏全没了;CSV 会重写时间戳,而「长时间未更新」是安全体检的一个计分维度——用 CSV 搬完家再跑体检,长期未更换这一维会被导入时刻洗掉,等于自欺欺人。
密码历史在任何路径下都不随搬家走,这是刻意的:历史快照是本地运维数据,不是账号凭据。
六、真正的备份是 .aph,不是表格
导出 CSV 需要主密码,但导出结果是明文——它是为了「喂给别的工具」,不是为了「存着」。加密备份走另一条路:
- 容器(版本号、导出时间、条目数、条目数据)序列化后一次性用 AES-256-GCM 加密,密钥由主密码经 PBKDF2-SHA256(60 万次迭代)派生,落盘的字节是「盐 ‖ IV ‖ 密文」三段拼接;
- 别把这件事和库本身的形态搞混:逐字段加密是
chrome.storage.local里存储的样子,备份容器整包加密是另一回事。两者都成立,但说的不是同一层; - 每次导出生成新的随机盐与 IV,同一份库导两次也不会得到相同的字节;
- 点击下载之前会做一次往返自检:把刚生成的文件解回来核对条目数与字段,对不上就不给你这个文件。这一步存在的理由很朴素——备份最坏的种类是「你以为有,打开才发现坏」。
导入 .aph 时必须输入导出时的主密码,不是当前会话的主密码。如果这两者不一样(比如你换过主密码),拿新密码解旧备份会失败——这是预期行为,不是 bug。
另外两个同名系列别混:.aphid 是个人信息库的加密备份,它保留 id 并按 id 合并(新 id 追加、更新时间更大的覆盖、其余跳过),跟密码库那种「追加不去重」正好是两种策略,因为个人信息那侧的身份标识是有意义的;.aphrecovery 是离线恢复套件,里面不含密码库,它解决的是「忘记主密码之后本机数据怎么救」。
七、站点规则也要搬
如果你以前调过按域名的填充入口覆盖、匹配范围之类的规则,这些不藏在密码库里,得单独导出单独导入。上限 500 条;文件大小按字符数近似到 2 MiB,且这道闸门排在 JSON.parse 之前。导入时接受带信封的结构和裸的「域名 → 规则」两种写法;逐条校验域名与选择器,非法或规范化后重复的计入「丢弃」;合并按规范化后的域名,同域名以导入为准。界面必须同时报出「新增 / 更新 / 丢弃」三个数——只报成功不报丢弃,等于让人以为搬全了。
八、代码里没有的东西
为了避免你在别处读到不实的说法,这份清单是我逐条在源码里确认过不存在的:
- 不支持 xlsx(只吃
.csv与.json,没有 Excel 解析器); - 没有导入时手动指定列的界面;
- 导入不做去重、不合并同账号;
- 导入不写密码历史;
- CSV 导出里没有收藏列。
这些都有替代路径(改表头、事后去重),但工具本身没做,就不该被描述成做了。
搬完家之后建议立刻做一件事:打开「加密备份导入」,把刚导出的那个 .aph 真的导一次,确认能解开、条数对得上。备份只有被还原成功过一次,才算存在过。
源码与讨论:GitHub 仓库。已上架 Chrome 应用商店,完全免费,GPL-3.0 开源。
本文涉及的关键文件:utils/excelFormatMap.ts(五套表头映射)、utils/excelCsv.ts(精确匹配→大小写回退、跳行规则、UTF-8/GBK 回退)、utils/excelJson.ts、utils/excelExport.ts(导出列与明文密码)、components/options/ImportDialog.vue(字节闸门与格式判定)、composables/useImportCapacity.ts(切片与二次确认)、utils/storage/passwordCrud.ts(整批原子写)、utils/backupExport.ts(.aph 容器、新盐新 IV、往返自检)、utils/identity/backup.ts(.aphid 按 id 合并)、utils/siteRulesTransfer.ts(规则迁移与 added/updated/dropped)。